DCD Connect 2026 e The Xcelerated Compute Show
Nos dias 4 e 5 de novembro, estive no Sheraton WTC, em São Paulo, acompanhando o DCD Connect Brasil 2026 e o The Xcelerated Compute Show. Foram dois dias de discussões sobre energia, infraestrutura para inteligência artificial, refrigeração e novos modelos de negócio para o setor.
O evento reuniu mais de 3,2 mil participantes, 170 palestrantes e 160 expositores. Além dos painéis tradicionais do DCD Connect, a programação contou com o Investment Forum e um espaço dedicado à computação acelerada, com a NVIDIA como lead partner.
Energia: o principal gargalo da IA
Um dos debates mais relevantes foi direto ao ponto: sem energia não há IA. Um dado apresentado durante o painel chamou atenção: a construção de um grande data center pode levar de 2 a 4 anos, enquanto a expansão da infraestrutura elétrica necessária pode levar de 6 a 8 anos.
Os pedidos de conexão, antes na faixa de 10 ou 20 MW, já chegam a 200 MW, e há projetos discutindo demandas de até 1 GW. Ou seja, o desafio não está apenas em comprar GPUs: é preciso conseguir energia para mantê-las operando.
A Ascenty apresentou o exemplo de Sumaré, onde investiu cerca de R$ 200 milhões em uma linha própria de 35 km para conectar seu campus a uma subestação. A discussão sobre permitir maior participação dos operadores na construção da infraestrutura elétrica merece atenção.
Outro ponto interessante foi a possibilidade de utilizar baterias, UPS e geradores dos data centers como recursos de flexibilidade para a rede elétrica, ajudando a reduzir picos de consumo. Se houver evolução regulatória, ativos que hoje ficam grande parte do tempo em espera poderão ter um papel adicional.
Também ficou claro que nem toda carga de IA precisa estar perto dos grandes centros consumidores. Treinamento e determinadas aplicações de inferência podem operar em regiões com energia e conectividade disponíveis. Isso abre espaço para novos polos fora do eixo Rio–São Paulo.
O mapa dos investimentos: Ceará em destaque
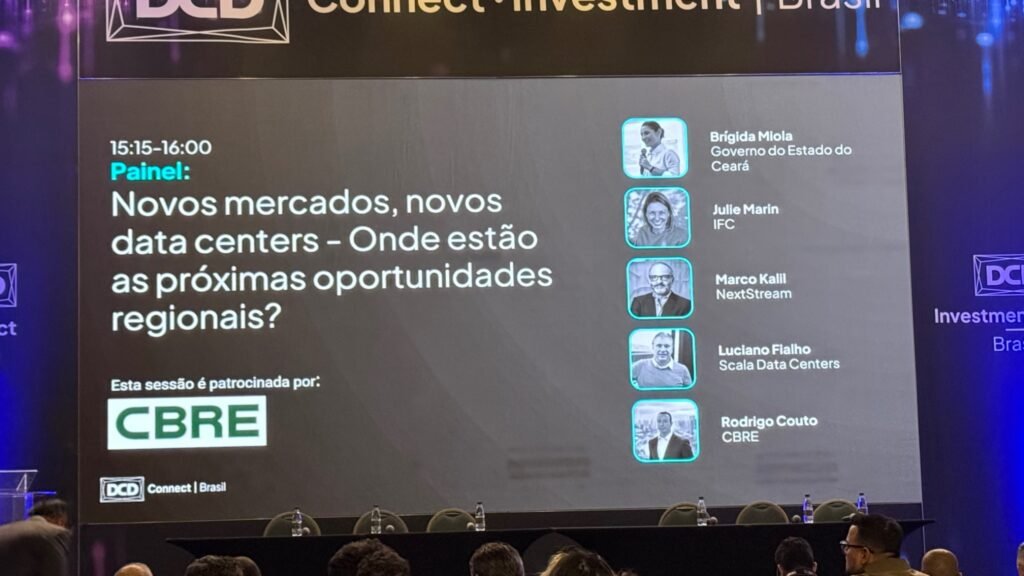
O painel “Novos mercados, novos data centers” reuniu representantes do Governo do Ceará, IFC, NextStream, Scala Data Centers e CBRE. A presença do Ceará na discussão não foi por acaso: o estado combina disponibilidade energética, conectividade internacional e projetos relevantes de infraestrutura digital, especialmente na região do Pecém.
Uma ausência que me chamou atenção foi Santa Catarina. Temos operadores, conectividade e uma posição interessante no Sul do país, mas ainda precisamos avançar para entrar com mais força nesse mapa de investimentos. Vejo nisso um desafio, mas também uma oportunidade.
Cooling: não existe uma solução única
Com o aumento da densidade das GPUs, a refrigeração deixou de ser um detalhe de projeto. Entre as alternativas discutidas, três tecnologias se destacam:
- Rear Door Heat Exchanger (RDHx): trocador de calor na porta traseira do rack. Pode ser um caminho para ampliar a densidade em salas existentes, sem uma reforma completa.
- Direct-to-Chip: líquido circula por cold plates instaladas diretamente nos componentes, como CPUs e GPUs. É indicado para ambientes de alta densidade e HPC.
- Immersion Cooling: servidores submersos em fluido dielétrico. É uma alternativa para cenários de densidade e exigência térmica extremas.
Como referência, a refrigeração a ar costuma atender racks na faixa de 10 a 15 kW, enquanto soluções líquidas podem chegar a densidades próximas de 100 kW por rack, conforme a arquitetura. Para quem já opera salas convencionais, a porta traseira pode ser um passo intermediário antes de partir para soluções mais complexas.
AI Factory por assinatura
No The Xcelerated Compute Show, a Positivo apresentou a linha IA Box, baseada no modelo Hardware as a Service (HaaS): em vez de comprar toda a infraestrutura, o cliente contrata uma mensalidade e mantém o equipamento em seu próprio ambiente.
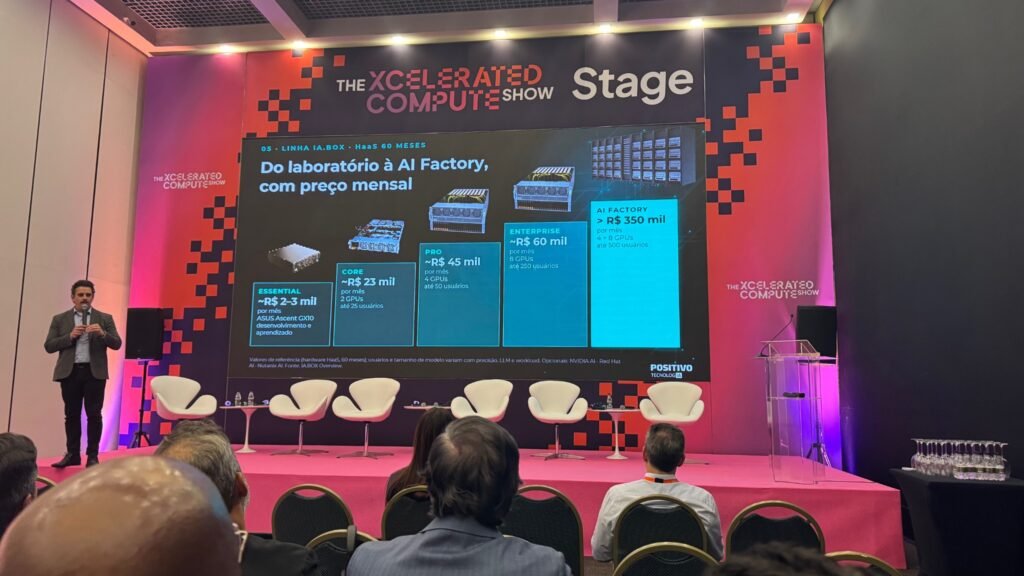
Os valores de referência exibidos no evento, para contratos de 60 meses, foram:
- Essential: R$ 2 mil a R$ 3 mil/mês, com ASUS Ascent GX10.
- Core: cerca de R$ 23 mil/mês, 2 GPUs e até 25 usuários.
- Pro: cerca de R$ 45 mil/mês, 4 GPUs e até 50 usuários.
- Enterprise: cerca de R$ 60 mil/mês, 6 GPUs e até 250 usuários.
- AI Factory: acima de R$ 350 mil/mês, com 4 ou mais GPUs e até 500 usuários.
A proposta chama atenção por ocupar um espaço entre consumir IA por APIs de hyperscalers e investir milhões em um cluster próprio. Para empresas que precisam manter dados e processamento sob seu controle, mas preferem evitar um CAPEX elevado, esse modelo pode fazer sentido.
Cloud, on-premise e o modelo híbrido
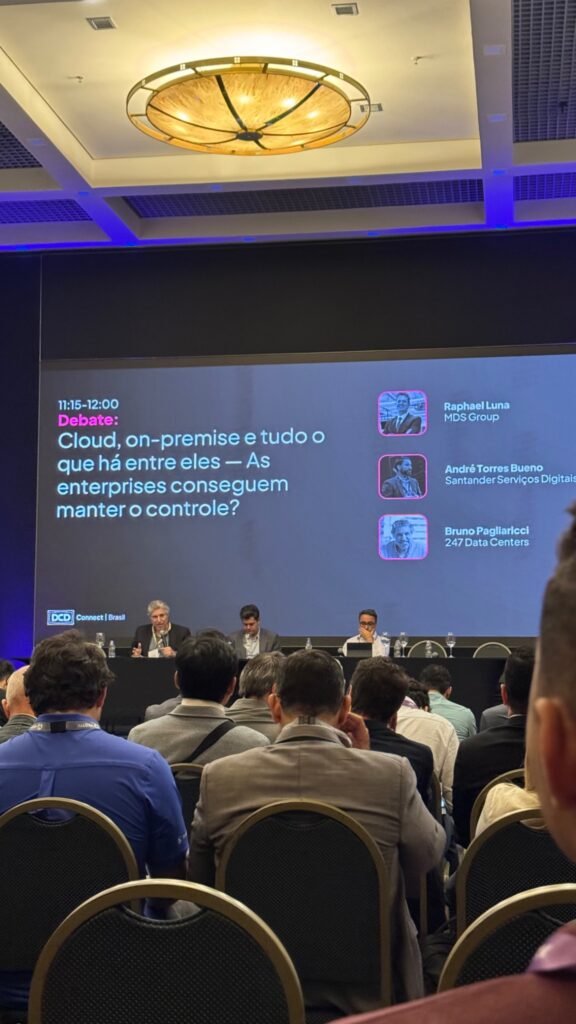
Outro debate abordou como as empresas podem manter o controle em ambientes que combinam cloud pública, infraestrutura própria e modelos híbridos.
Na prática, a decisão não deveria ser simplesmente cloud ou on-premise. Cada workload precisa estar no ambiente mais adequado, considerando custo, desempenho, segurança, latência, disponibilidade e requisitos regulatórios. O desafio é manter governança e visibilidade sobre toda essa operação.
O que fica do DCD Connect 2026
Minha principal impressão é que a expansão da inteligência artificial está trazendo o debate de volta aos fundamentos da infraestrutura. Antes de falar em grandes clusters, precisamos resolver energia, refrigeração, conectividade e capacidade física.
Três pontos resumem o que levo do evento:
- Energia é estratégica: precisa entrar no planejamento desde o início, pois pode definir onde e quando um data center será viável.
- Cooling precisa acompanhar a densidade: a tecnologia deve ser escolhida conforme o workload, a infraestrutura existente e o TCO.
- IA como serviço abre novas oportunidades: existe mercado entre a API de terceiros e o investimento em infraestrutura própria.
Estamos entrando em uma nova fase para os data centers. A inteligência artificial não muda apenas os servidores: muda o planejamento de energia, refrigeração, conectividade, armazenamento e os próprios modelos de negócio.
O Brasil tem potencial para ocupar um espaço importante nessa transformação. A questão é se conseguiremos transformar esse potencial em infraestrutura digital, com energia e capacidade disponíveis onde o mercado precisa.
Até o próximo evento, pessoal!
IBM TechXchange 2026 – Atlanta
Se o VMware Explore foi a Broadcom tentando fazer as pazes com o cliente, o IBM TechXchange 2026 foi a IBM tentando colocar limites em agente de IA. Passei a semana de 26 a 29 de outubro em Atlanta, no Georgia World Congress Center, e o recado do evento inteiro cabe numa frase do keynote de abertura do Dinesh Nirmal (SVP de Software da IBM): só uns 25% dos agentes de IA hoje estão prontos pra rodar em empresa. Os outros 75% são prompt solto com acesso a sistema de produção.
O TechXchange é o evento técnico da IBM (o Think é o executivo; esse aqui é o de quem bota a mão na stack). Mais de 5,4 mil pessoas de 76 países, mais de mil sessões, e uma novidade de formato: a HashiConf rodou dentro do TechXchange. Isso explica por que Terraform e Vault apareceram em quase toda conversa.
Agente sem dono não entra: Agent Identity e Vault 2.2
O anúncio que amarra o evento inteiro é o IBM Agent Identity, no dia 26, junto com o HashiCorp Vault 2.2. A ideia é simples de explicar e difícil de fazer: todo agente vira uma identidade com dono, inventário e missão, recebe credencial efêmera (token de curta duração, escopo por tarefa) e pode ter a sessão revogada em tempo real. Tentou fazer algo fora da permissão, a sessão cai na hora. O Vault emite a credencial just-in-time, e tudo fica numa trilha de auditoria ligando humano, agente e ação.
É o crachá de visitante que expira no fim do dia, só que pra software. Hoje a maioria das empresas dá ao agente o crachá do diretor e torce.
watsonx Orchestrate quer ser o controle, não a fábrica
A segunda peça é o watsonx Orchestrate, que ganhou um AI Gateway único pra descobrir, conter e avaliar agentes, inclusive os que não são da IBM: Amazon Bedrock, Microsoft Foundry e Google Gemini. Discover e Contain (sandbox isolado com kill switch) estão em tech preview; Evaluate já está disponível, com LLM-as-a-judge e trace passo a passo do que o agente fez. Tem ainda um Premium Runtime com isolamento por hardware.
A IBM entendeu que não vai ganhar a corrida de quem constrói o melhor agente. Então está se posicionando como a camada de governança por cima dos agentes dos outros. É middleware, de novo. Coerente com o histórico deles.
Concert: Instana, Turbonomic, SevOne e AIOps numa coisa só
Pra quem é de operação, o anúncio mais prático foi o IBM Concert virando plataforma unificada: observabilidade full-stack (Instana), observabilidade de rede (SevOne), otimização de capacidade (Turbonomic), gestão de incidentes (o antigo Cloud Pak for AIOps) e vulnerabilidades com prova de exploitabilidade. Roda em SaaS ou on-prem, e podemos definir o que automatiza e o que precisa de aprovação.
Para operadora, correlação app + infra + rede num lugar só é exatamente a dor que a gente vive no NOC: o alarme nasce na rede, aparece na aplicação e o ticket cai na infra. Vale PoC.
HashiConf dentro do TechXchange: Terraform pra agentes
Com a HashiConf integrada, o Terraform teve sua própria rodada de anúncios. O Terraform policy (policy-as-code em HCL, com conversor pra quem vem de Sentinel e OPA) . O Developer Portal (self-service governado: o time de plataforma define o padrão, dev e agente consomem) e o servidor MCP remoto do HCP Terraform estão em public preview.
A lógica: um agente (citaram IBM Bob, Claude Code, Copilot e Cursor) descobre módulos aprovados e gera código no padrão da empresa, com a mesma autenticação e as mesmas permissões de um humano. Traduzindo: o agente não ganha atalho. Entra pela mesma porta que você.
Supply chain open source: Bob DevSecOps e a Lightwell
O IBM Bob, o agente de desenvolvimento da IBM (já com 170 mil usuários, dois terços deles não desenvolvedores), ganhou um pacote premium de DevSecOps. O recurso que mais me chamou atenção é o SafeWrite: ele intercepta a edição de arquivo ou a instalação de pacote que o agente de IA propôs, antes de chegar no disco, e troca a dependência vulnerável pela versão corrigida mais próxima. Se não tem correção conhecida, bloqueia. Além disso, SAST em tempo real e review de pull request, que chega em novembro pra GitHub.
Nas sessões da Red Hat, o assunto dominante foi a Lightwell, a iniciativa IBM + Red Hat anunciada em maio com US$ 5 bilhões e 20 mil engenheiros pra remediar vulnerabilidade em open source com IA. Em outubro divulgaram mais de 400 vulnerabilidades inéditas corrigidas em bibliotecas Java; a promessa no título das sessões era patch de 90 pra 7 dias. A fase comercial começou por financeiro; telecom está na lista de expansão. Vou acompanhar.
Pós-quântico saiu do PowerPoint
O IBM Quantum Safe virou uma suíte de verdade: Cryptography Manager (inventário e migração), Explorer (varre o código e gera CBOM, o “bill of materials” criptográfico) e Proxy (deixa cliente legado conviver com servidor já pós-quântico). Os prazos regulatórios que eles citaram começam em 2030, e o argumento do “harvest now, decrypt later” vale pra qualquer dado que precisa ficar sigiloso por mais de cinco anos. Certificado, VPN e dado de assinante entram nessa conta.
Se você ainda não tem inventário criptográfico, 2027 é um bom ano pra começar. Não porque o quântico chega em 2027, mas porque inventário de certificado em empresa grande demora mais do que a gente admite.
E a infraestrutura? Evolução, sem lançamento
Vou ser direto: não teve anúncio novo de Power nem de Storage nessa edição. O Power11 é de julho de 2025 e a família FlashSystem 5600/7600/9600 saiu em fevereiro. O que teve foi evolução em volta do que já existe:
- Spyre, o acelerador de IA da IBM, agora roda modelos do Hugging Face e vLLM via integração profunda com PyTorch (anúncio de 17/10, reforçado no evento). Pra inferência em Power sem GPU, começa a ficar interessante.
- OpenShift Virtualization teve deep dive de storage (CSI, storage class pra VM, live migration, snapshot, clone, HA e DR). Pra quem avalia uma segunda plataforma de virtualização depois do licenciamento da Broadcom, é sinal de maturidade.
- IBM Fusion com OpenShift apareceu no user group da Red Hat, junto com o caso interno da própria IBM (“Client Zero”).
- Inferência distribuída com llm-d e vLLM, e um lab de “Model-as-a-Service” privado com controle de acesso e métrica de uso pra chargeback. Pra quem entrega cloud pra cliente, como a gente, isso é produto pronto pra copiar.
- Instana + Event-Driven Ansible + agentes via MCP fechando o loop de AIOps, com RBAC e aprovação humana antes de executar a remediação.
Resumo do TechXchange 2026
A IBM deslocou o centro de gravidade de “modelo” pra “agente governado” e reorganizou o portfólio inteiro (Orchestrate, Concert, Verify, Vault, Terraform) em torno de três palavras: identidade, controle e operação. Pra quem roda infraestrutura e cloud, o que importa não é a fábrica de agentes. É a camada de baixo: segredo, política, observabilidade e plataforma Kubernetes/virtualização. IBM e Red Hat estão tratando isso como pré-requisito, e eu concordo.
E a parte boa é que quase tudo que vi dá pra experimentar em escala pequena antes de qualquer compromisso: Vault pra credencial efêmera, policy-as-code no Terraform, um PoC de Concert num domínio só, um cluster de OpenShift Virtualization. Arquitetura primeiro, contrato depois. É por aí que eu começaria.
Se você só tem tempo pra acompanhar uma coisa desse evento, é o Agent Identity. O resto orbita em volta dele.
O TechXchange 2027 já tem data: 8 a 11 de novembro de 2027, de novo em Atlanta. Até o próximo evento, pessoal!
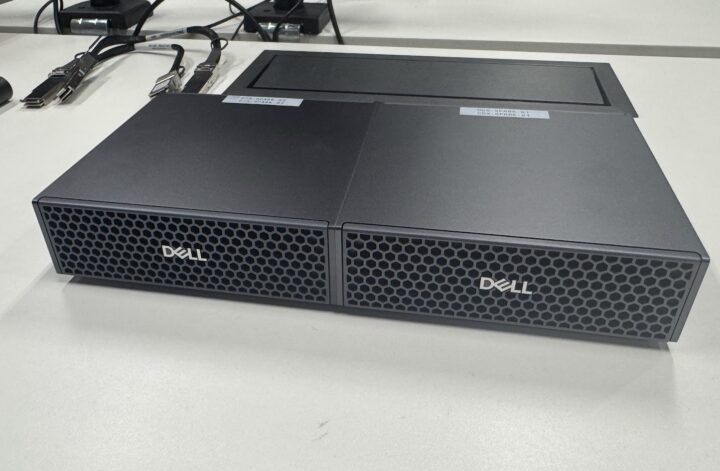
Dell Pro Max GB10: aparência despretensiosa, um supercomputador de IA por dentro.
Deixa eu começar pelo problema, como sempre gosto de fazer.
O jogo virou: você não contrata mais infra, você aluga tokens
Durante quinze anos a conta era simples. Você queria capacidade? Comprava servidor, dimensionava CPU, memória, storage. A dor era CAPEX. Hoje, quando uma empresa quer colocar IA pra dentro, a pergunta mudou. Ninguém pergunta “quantos núcleos eu preciso”. A pergunta virou “quantos tokens por mês eu vou queimar?”.
E aqui mora a armadilha. Token é o novo aluguel. É bonito no começo, você não compra nada, sobe uma API, paga pelo uso. Mas todo mundo que já passou por isso sabe: o modelo de “pague pelo uso” é maravilhoso até o uso virar rotina. Aí a fatura da OpenAI, da Anthropic ou do provedor da vez começa a subir de forma silenciosa e mensal, igual assinatura de streaming que você esqueceu de cancelar, só que com três zeros a mais.
Gosto de pensar que a IA repetiu o mesmo ciclo da nuvem: primeiro todo mundo migra encantado com o “sem servidor pra gerenciar”, e uns anos depois começa o movimento de trazer carga de volta pra casa porque a conta não fechou. Token é OPEX puro. E OPEX que cresce sem teto é dívida técnica disfarçada de conveniência.
É nesse ponto que o GB10 entra na conversa.
O que é o Dell Pro Max GB10 (e por que ele não é “só mais um mini PC”)
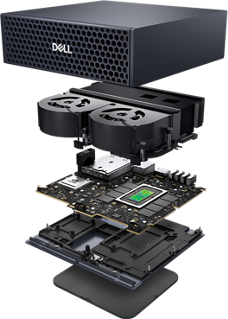
Por baixo do chassi: o NVIDIA GB10 Grace Blackwell Superchip.
Esqueça a aparência. Este tijolinho preto de aparência despretensiosa é, na prática, um supercomputador de IA de mesa. Por baixo do chassi ele carrega o NVIDIA GB10 Grace Blackwell Superchip, e os números fazem você repensar o que “desktop” significa:
- CPU Grace de 20 núcleos Arm (10 Cortex-X925 + 10 Cortex-A725)
- GPU Blackwell com 6.144 núcleos CUDA
- Até 1 PetaFLOP (1.000 TFLOPS) de desempenho em FP4
- 128 GB de memória unificada LPDDR5x CPU e GPU compartilhando o mesmo pool, sem cópia de dados de um lado pro outro
- 273 GB/s de banda de memória
- SSD Gen5 de 4 TB
- NIC ConnectX-7 com par de portas QSFP para 200 Gbit de rede
- Vem com o NVIDIA DGX OS já pronto, drivers, CUDA e frameworks (PyTorch, TensorFlow) pré-configurados
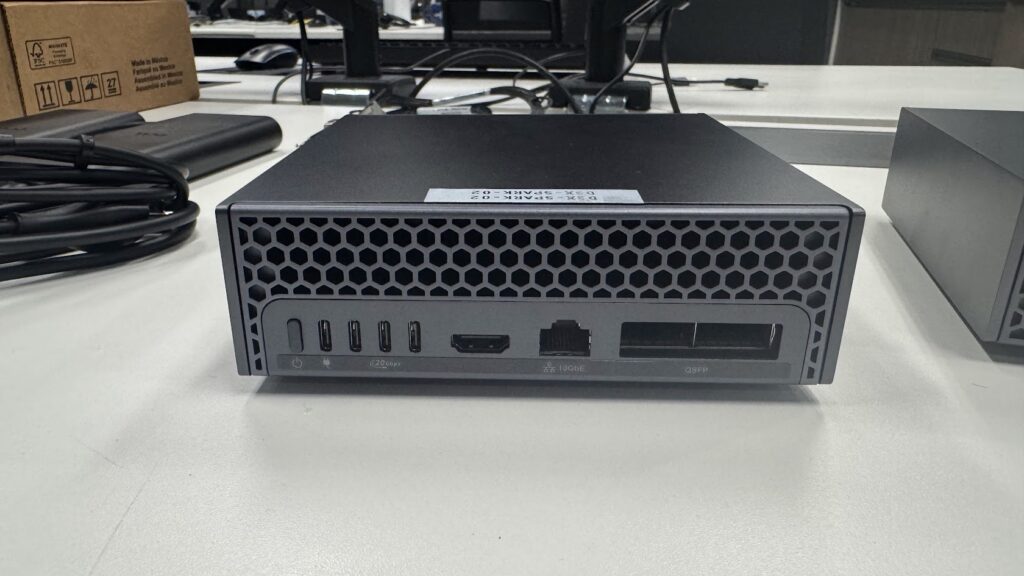
Conectividade: 4x USB-C 20Gbps, HDMI, 10GbE e o par de portas QSFP de 200 Gbit.
Traduzindo o número que mais importa: 128 GB de memória unificada é o que muda tudo. Numa GPU de jogo tradicional, você esbarra nos 12, 16, 24 GB de VRAM e o modelo simplesmente não cabe. Aqui, CPU e GPU bebem da mesma fonte de 128 GB. É por isso que esse aparelhinho aguenta modelos de até 200 bilhões de parâmetros rodando localmente, se você juntar duas unidades pelas portas QSFP, chega a modelos ainda maiores.
O teste: Llama de 8 bilhões de parâmetros, sem tocar na nuvem
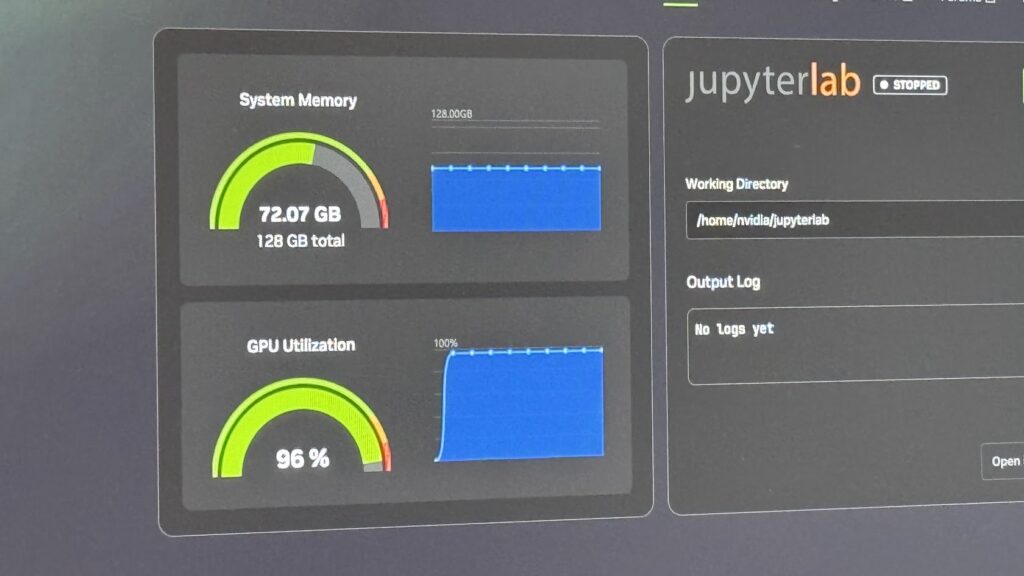
72 GB de memória em uso, GPU cravada em 96%: o hardware sendo realmente exigido.
Foi aqui que a ficha caiu de vez.
Eu não fui o piloto dessa vez, acompanhei dois amigos entusiastas colocando a mão na massa: um DevOps (Jardel) e um Tech Leader (Douglas). E confesso que aprender vendo gente boa operar às vezes rende mais do que fazer sozinho. Eles subiram um Llama de 8 bilhões de parâmetros local, sem depender de nenhuma API externa, e colocaram pra trabalhar.
O painel conta a história sozinho: 72 GB de memória em uso, GPU cravada em 96%. Ou seja, o hardware estava sendo realmente exigido, e ainda sobrava folga na memória pra crescer.
Pare pra pensar no que isso representa na prática:
- Zero tokens gastos. Cada inferência que roda ali é uma inferência que não apareceu na fatura da nuvem.
- Zero dado saindo de casa. Prompt, documento, informação de cliente, nada trafega pra fora. Pra quem lida com LGPD, jurídico ou saúde, isso sozinho já justifica o investimento.
- Latência previsível. Sem depender de fila de API, sem rate limit, sem “modelo indisponível no momento”.
Um Llama de 8B como esse dá conta com sobra de RAG, sumarização, extração de dados, chatbot interno, classificação, apoio a código. É exatamente o feijão com arroz da IA corporativa, e é justamente essa carga repetitiva e de alto volume que mais dói na conta de tokens quando roda na nuvem.
A conta que ninguém faz: CAPEX de uma vez contra OPEX pra sempre
Um aparelho desses custa, arredondando, algo na casa dos US$ 4 mil, uma vez. Compare com o que uma equipe de desenvolvimento ou um produto interno queima em tokens de API rodando dia e noite. Em muitos cenários que já vi, o equipamento se paga em meses, não em anos. Dali pra frente, cada inferência é praticamente de graça, você já pagou pelo hardware.
É a mesma lógica de sempre, só que aplicada a um mundo novo: infraestrutura própria é um custo que você amortiza; token de nuvem é uma torneira que nunca fecha. Não estou dizendo pra abandonar a nuvem, estou dizendo pra parar de usar a Ferrari da API premium pra buscar pão na padaria. A carga de trabalho pesada, sensível e repetitiva desce pra casa. A nuvem fica pro que é de fato eventual, gigante ou de fronteira.
Isso é FinOps aplicado à IA. E FinOps, no fim das contas, é só arquitetura com a calculadora na mão.
E não, isso não é brinquedo de mesa: já tem gente rackeando em datacenter
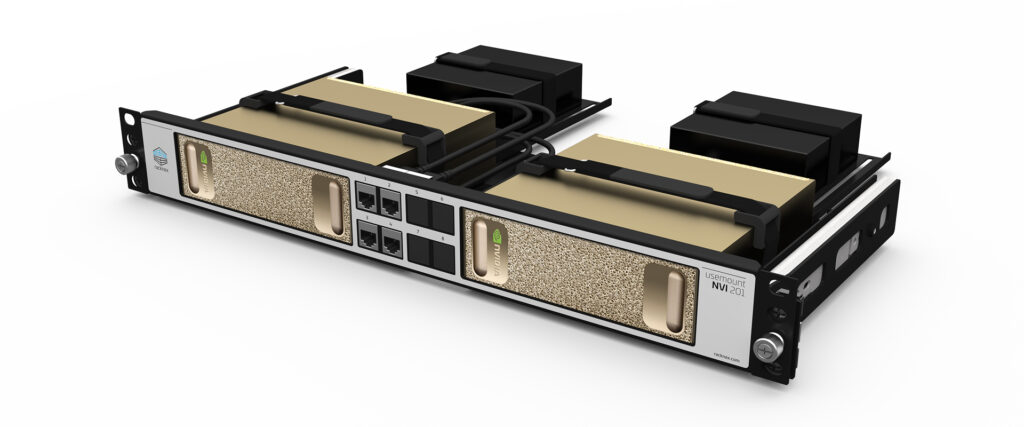
Esse foi o ponto que mais me surpreendeu na pesquisa.
Muita gente olha pra esse formato de “mini PC” e pensa em uso de mesa, de desenvolvedor. Mas as empresas já entenderam a jogada e estão colocando esses aparelhos dentro do datacenter. Como? Em gavetas (trays) específicas de rack. Já existem kits homologados de rackmount que acomodam duas unidades GB10 em pouco mais de 1U de um rack padrão de 19”, com as portas roteadas pra frente e tudo organizado, e esses kits suportam explicitamente o Dell Pro Max com GB10, além dos equivalentes de Acer, ASUS, GIGABYTE e Lenovo que usam o mesmo superchip.
Ou seja: o que começa como “um teste na mesa de dois amigos” vira, sem drama nenhum, uma fileira de nós de inferência empilhados no rack, cada um servindo seus modelos locais, interligados pelas portas QSFP de 200 Gbit. É um jeito completamente novo de montar capacidade de IA, modular, denso, energeticamente eficiente (o conjunto todo vive de uma fonte USB-C de ~280W) e, principalmente, sem uma fatura de tokens crescendo no fim do mês.
O que eu levo desse teste
O GB10 não vai substituir a nuvem, e nem é essa a proposta. O que ele faz é te devolver uma escolha que a IA-como-serviço tinha tirado da mesa: decidir o que roda dentro de casa e o que vale a pena alugar.
E essa escolha é, no fundo, uma decisão de arquitetura, não de hardware. Quem trata IA só como “assinar uma API” vai descobrir, lá na frente, que terceirizou junto o controle do próprio custo. Quem senta, dimensiona e decide onde cada carga deve viver, continua no comando.
Porque no fim, seja em virtualização, em nuvem ou em IA, o princípio não muda:
A tecnologia mudou o vilão da conta. Mas quem manda na conta continua sendo a arquitetura.
Ficou curioso pra saber se faz sentido trazer inferência pra dentro da sua operação? Me procure — adoro discutir esse tipo de conta.
Por trás do Pandora — O cluster que não dorme
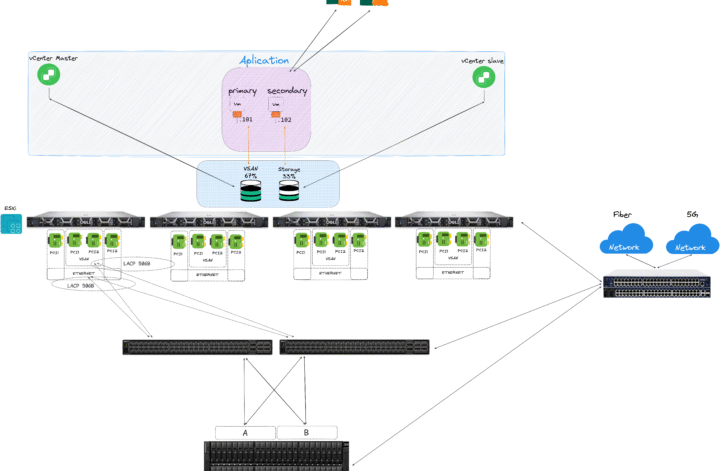
O Cluster Pandora nasceu dentro da Unifique Cloud com um propósito ousado: garantir que a gestão e os serviços críticos do ambiente permaneçam operacionais mesmo diante de falhas severas de storage, rede ou virtualização.
Mais do que um cluster de gerenciamento, o Pandora é um núcleo autônomo e distribuído de controle e orquestração, construído para operar de forma independente e manter a Unifique Cloud sob controle — mesmo quando o resto do ambiente para.
O Desafio
Em uma infraestrutura moderna, quase tudo depende da camada de gerenciamento.
Mas o time da Unifique Cloud percebeu um ponto cego:
“E se o próprio ambiente de controle cair junto com o restante da infraestrutura?”
A resposta foi criar um cluster isolado, resiliente e autossustentável, espalhado por locais físicos diferentes da infraestrutura principal, garantindo continuidade operacional e independência total.
Assim nasceu o Projeto Pandora — o cluster que não dorme.
A Arquitetura
O Pandora foi projetado sobre processadores AMD EPYC, que entregam alta densidade de núcleos, performance térmica eficiente e confiabilidade sob carga constante.
Seu armazenamento é 100% baseado em discos NVMe, garantindo latência ultrabaixa e throughput máximo, mesmo em cenários de operações simultâneas de backup, replicação e orquestração.
Cada host está conectado a todos os Top of Rack (ToR) do datacenter, com uplinks redundantes e um canal WAN exclusivo, permitindo acesso remoto e gestão plena mesmo em situações de isolamento da rede interna.
Além disso, o cluster é geograficamente distribuído, aumentando ainda mais sua tolerância a falhas físicas e elétricas.
O armazenamento roda sobre VMware vSAN configurado em RAID1, assegurando espelhamento de dados entre hosts.
E, indo além da replicação, os serviços foram intencionalmente distribuídos entre o vSAN e storages dedicadas — exemplo: quatro controladores de domínio (AD), sendo dois no vSAN e dois em storage independente.
Mesmo em uma falha total de um dos sistemas de armazenamento, os serviços de autenticação e diretório seguem em operação.
Serviços Críticos Hospedados
O Pandora é o ponto de sustentação da Unifique Cloud, abrigando não só a camada de gerenciamento, mas também serviços de produção utilizados por clientes.
Dentro dele rodam:
- vCenter, VMware Cloud e NSX Manager – o coração da virtualização e SDN.
- Veeam Backup & Replication – Backup Server incluindo o serviço de Cloud Connect entregue aos clientes Unifique.
- Active Directory e PAM – autenticação, segurança e controle de privilégios.
- Kubernetes Cluster e Load Balancer – orquestração e entrega de microsserviços internos.
- Soluções de monitoramento da Cloud – visibilidade completa da operação.
- Portais e dashboards das nuvens – interface de gestão e provisionamento.
- Sistemas de inventário, como o NextBox – controle de ativos e topologia.
Com esse desenho, o Pandora garante que, mesmo durante falhas severas em storages, leafs, spines ou clusters VMware, a gestão, o monitoramento e os serviços críticos continuem operando de forma independente.
O Pandora é um ambiente construído para não ser usado — como um seguro de carro: você espera nunca precisar, mas dorme tranquilo sabendo que está protegido.
Ele existe para garantir que, em um cenário de contingência total, a Unifique nunca fique no escuro.
Mesmo que o ambiente principal sofra interrupções graves, o Pandora mantém viva a inteligência e o comando da operação.
Resiliência Total
O projeto foi desenhado para resistir a falhas múltiplas e simultâneas:
- Falha de storage? Aplicações redundantes continuam disponíveis.
- Perda de leaf ou spine? Conectividade mantida pelos ToRs ativos.
- Clusters VMware fora do ar? O Pandora segue orquestrando o ambiente e coordenando a recuperação.
Os backups seguem a política 3-2-1, armazenados em storage dedicada e replicados para appliance S3 imutável, protegendo contra falhas físicas, humanas e lógicas.
Resultado
O Cluster Pandora consolidou-se como o núcleo de resiliência e governança distribuída da Unifique Cloud.
Mais do que um projeto técnico, ele representa uma filosofia de engenharia:
Alta disponibilidade não é um recurso. É uma mentalidade.
E quando o inesperado acontece, o Pandora está lá — garantindo que a Unifique siga no comando.
Dell EMC Networking VEP1485 – Edge Computing

Olá pessoal, todos bem?
Consegui um Hardware da DELL para laboratório chamado VEP “Virtual Edge Platform” para rodar em meu HomeLab. E o resultado dos testes foi além do esperado. Gostaria de elencar abaixo alguns dos pontos que me fez adorar este Hardware, principalmente para fazer a função de Edge mas também como um excelente equipamento para ter em casa e executar laboratórios.
- Baixo consumo de Energia (Monitorei a alimentação deste Hardware e o seu consumo é de 35 a 45W .
- Tamanho reduzido, diferente de um servidor de Rack este Hardware tem o tamanho de um ThinClient.
- Recurso de Hardaware bem interessante (16 Cores, 64GB RAM , 2 TB SSD, 6 Interfaces 1GB e 2 Interfaces 10GB SFP+)
Hoje em dia falamos muito da Jornada de migrar nossas aplicações para Nuvem, porém algumas aplicações ainda são sensíveis com questão de latência, podemos imaginar que boa parte das aplicações estejam rodando na Nuvem.
Vamos imaginar o seguinte cenário onde você precisa manter localmente serviços como um Controlador de Domínio ou algum servidor de aplicação que depende de latência baixa e com a adoção deste Hardware você pode deixar suas máquinas virtuais ou até mesmo containers rodando neste equipamento com uma réplica para Nuvem configurada.
Com a replica das máquinas deste equipamento para Nuvem no caso de um sinistro você até pode sofrer com latência, porém garante a continuidade da sua operação até realizar o FailBack.
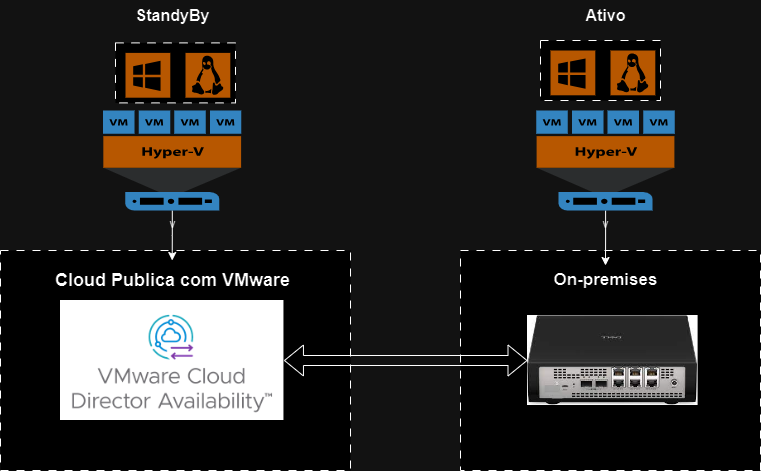
O caso acima é um exemplo simples que pode ser implementando de várias formas, replicando com VMware fazendo uma nuvem estendida. Também é possível utilizar o VEEAM caso o Datacenter trabalhe com CloudConnect da VEEAM , você pode replicar essa máquina para dentro do seu tennant no VMware Cloud Director.
Abaixo gosto de mostrar um exemplo real e simples com VEEM , aonde o print é exatamente um ESXI rodando no VEP com várias maquinas virtuais como de VEEAM, PFsense, AD, DNS e WTS. Sendo muito parecido com senário de muitos clientes.

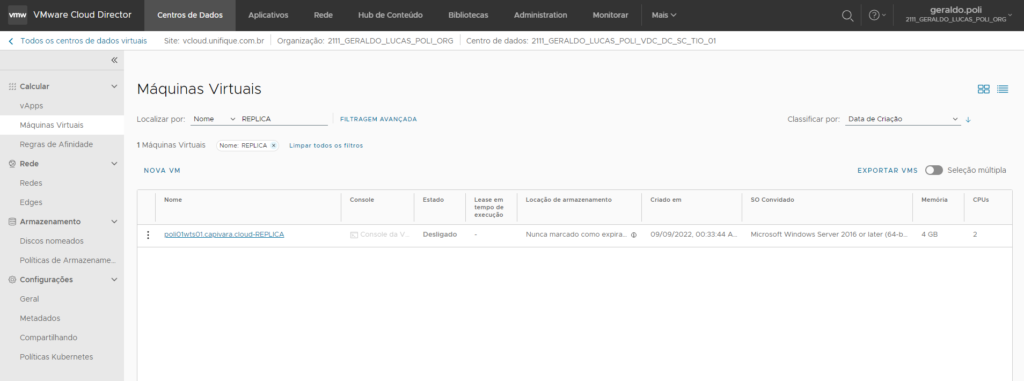
Foi criado no VEEAM uma réplica utilizando o CloudConnect e conforme a imagem abaixo minha VM de WTS já está replicada e aguardando ser iniciada na Cloud caso aconteça algum sinistro na borda. Isso é possível com o DR Planning no Veeam.
Claro existe várias questões de remap de rede e roteamentos que precisam ser ajustadas para rodar na Nuvem, mas este não é o foco deste tópico.
Vamos Falar um puco sobre este equipamento?