DCD Connect 2026 e The Xcelerated Compute Show
Nos dias 4 e 5 de novembro, estive no Sheraton WTC, em São Paulo, acompanhando o DCD Connect Brasil 2026 e o The Xcelerated Compute Show. Foram dois dias de discussões sobre energia, infraestrutura para inteligência artificial, refrigeração e novos modelos de negócio para o setor.
O evento reuniu mais de 3,2 mil participantes, 170 palestrantes e 160 expositores. Além dos painéis tradicionais do DCD Connect, a programação contou com o Investment Forum e um espaço dedicado à computação acelerada, com a NVIDIA como lead partner.
Energia: o principal gargalo da IA
Um dos debates mais relevantes foi direto ao ponto: sem energia não há IA. Um dado apresentado durante o painel chamou atenção: a construção de um grande data center pode levar de 2 a 4 anos, enquanto a expansão da infraestrutura elétrica necessária pode levar de 6 a 8 anos.
Os pedidos de conexão, antes na faixa de 10 ou 20 MW, já chegam a 200 MW, e há projetos discutindo demandas de até 1 GW. Ou seja, o desafio não está apenas em comprar GPUs: é preciso conseguir energia para mantê-las operando.
A Ascenty apresentou o exemplo de Sumaré, onde investiu cerca de R$ 200 milhões em uma linha própria de 35 km para conectar seu campus a uma subestação. A discussão sobre permitir maior participação dos operadores na construção da infraestrutura elétrica merece atenção.
Outro ponto interessante foi a possibilidade de utilizar baterias, UPS e geradores dos data centers como recursos de flexibilidade para a rede elétrica, ajudando a reduzir picos de consumo. Se houver evolução regulatória, ativos que hoje ficam grande parte do tempo em espera poderão ter um papel adicional.
Também ficou claro que nem toda carga de IA precisa estar perto dos grandes centros consumidores. Treinamento e determinadas aplicações de inferência podem operar em regiões com energia e conectividade disponíveis. Isso abre espaço para novos polos fora do eixo Rio–São Paulo.
O mapa dos investimentos: Ceará em destaque
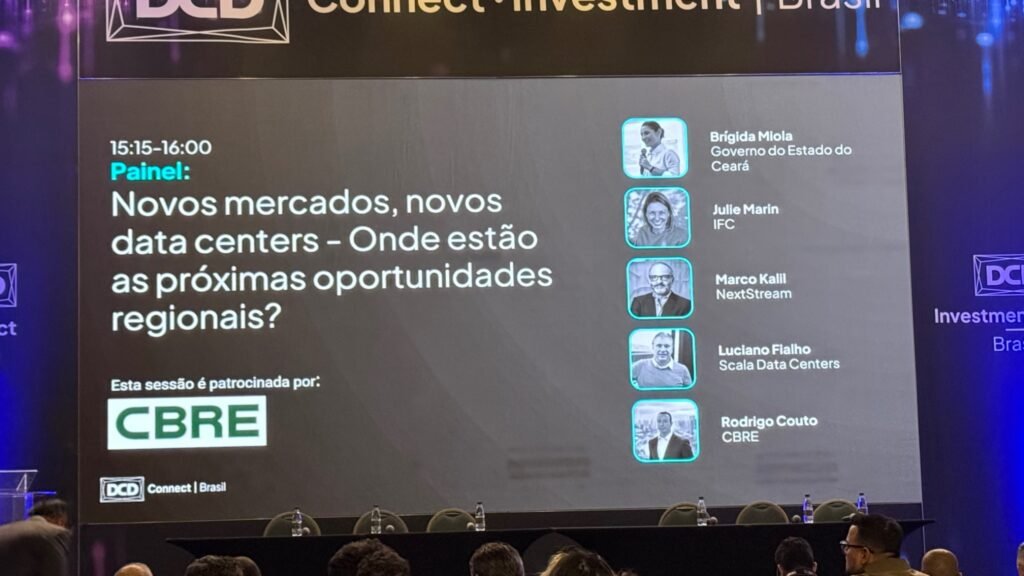
O painel “Novos mercados, novos data centers” reuniu representantes do Governo do Ceará, IFC, NextStream, Scala Data Centers e CBRE. A presença do Ceará na discussão não foi por acaso: o estado combina disponibilidade energética, conectividade internacional e projetos relevantes de infraestrutura digital, especialmente na região do Pecém.
Uma ausência que me chamou atenção foi Santa Catarina. Temos operadores, conectividade e uma posição interessante no Sul do país, mas ainda precisamos avançar para entrar com mais força nesse mapa de investimentos. Vejo nisso um desafio, mas também uma oportunidade.
Cooling: não existe uma solução única
Com o aumento da densidade das GPUs, a refrigeração deixou de ser um detalhe de projeto. Entre as alternativas discutidas, três tecnologias se destacam:
- Rear Door Heat Exchanger (RDHx): trocador de calor na porta traseira do rack. Pode ser um caminho para ampliar a densidade em salas existentes, sem uma reforma completa.
- Direct-to-Chip: líquido circula por cold plates instaladas diretamente nos componentes, como CPUs e GPUs. É indicado para ambientes de alta densidade e HPC.
- Immersion Cooling: servidores submersos em fluido dielétrico. É uma alternativa para cenários de densidade e exigência térmica extremas.
Como referência, a refrigeração a ar costuma atender racks na faixa de 10 a 15 kW, enquanto soluções líquidas podem chegar a densidades próximas de 100 kW por rack, conforme a arquitetura. Para quem já opera salas convencionais, a porta traseira pode ser um passo intermediário antes de partir para soluções mais complexas.
AI Factory por assinatura
No The Xcelerated Compute Show, a Positivo apresentou a linha IA Box, baseada no modelo Hardware as a Service (HaaS): em vez de comprar toda a infraestrutura, o cliente contrata uma mensalidade e mantém o equipamento em seu próprio ambiente.
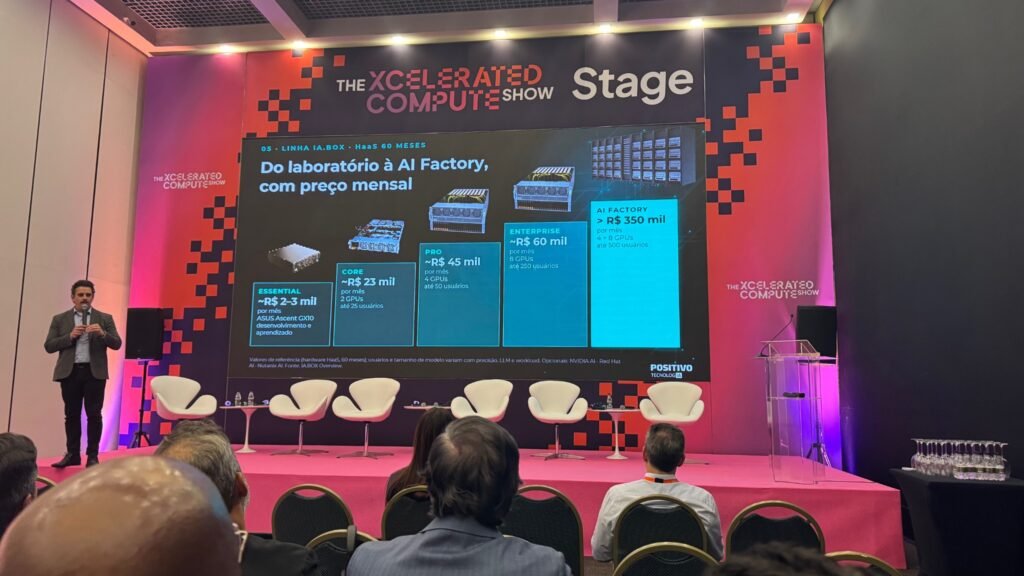
Os valores de referência exibidos no evento, para contratos de 60 meses, foram:
- Essential: R$ 2 mil a R$ 3 mil/mês, com ASUS Ascent GX10.
- Core: cerca de R$ 23 mil/mês, 2 GPUs e até 25 usuários.
- Pro: cerca de R$ 45 mil/mês, 4 GPUs e até 50 usuários.
- Enterprise: cerca de R$ 60 mil/mês, 6 GPUs e até 250 usuários.
- AI Factory: acima de R$ 350 mil/mês, com 4 ou mais GPUs e até 500 usuários.
A proposta chama atenção por ocupar um espaço entre consumir IA por APIs de hyperscalers e investir milhões em um cluster próprio. Para empresas que precisam manter dados e processamento sob seu controle, mas preferem evitar um CAPEX elevado, esse modelo pode fazer sentido.
Cloud, on-premise e o modelo híbrido
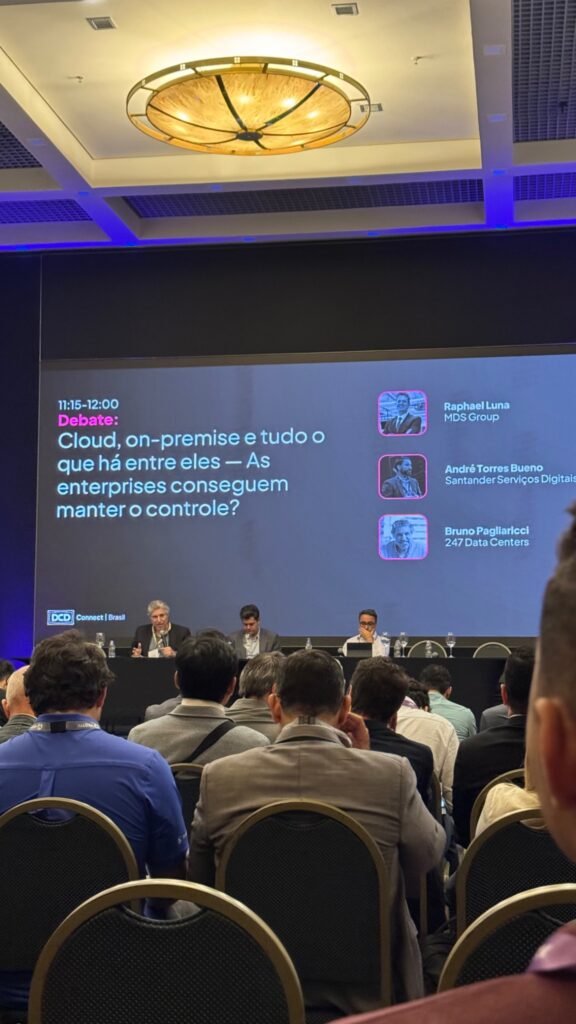
Outro debate abordou como as empresas podem manter o controle em ambientes que combinam cloud pública, infraestrutura própria e modelos híbridos.
Na prática, a decisão não deveria ser simplesmente cloud ou on-premise. Cada workload precisa estar no ambiente mais adequado, considerando custo, desempenho, segurança, latência, disponibilidade e requisitos regulatórios. O desafio é manter governança e visibilidade sobre toda essa operação.
O que fica do DCD Connect 2026
Minha principal impressão é que a expansão da inteligência artificial está trazendo o debate de volta aos fundamentos da infraestrutura. Antes de falar em grandes clusters, precisamos resolver energia, refrigeração, conectividade e capacidade física.
Três pontos resumem o que levo do evento:
- Energia é estratégica: precisa entrar no planejamento desde o início, pois pode definir onde e quando um data center será viável.
- Cooling precisa acompanhar a densidade: a tecnologia deve ser escolhida conforme o workload, a infraestrutura existente e o TCO.
- IA como serviço abre novas oportunidades: existe mercado entre a API de terceiros e o investimento em infraestrutura própria.
Estamos entrando em uma nova fase para os data centers. A inteligência artificial não muda apenas os servidores: muda o planejamento de energia, refrigeração, conectividade, armazenamento e os próprios modelos de negócio.
O Brasil tem potencial para ocupar um espaço importante nessa transformação. A questão é se conseguiremos transformar esse potencial em infraestrutura digital, com energia e capacidade disponíveis onde o mercado precisa.
Até o próximo evento, pessoal!
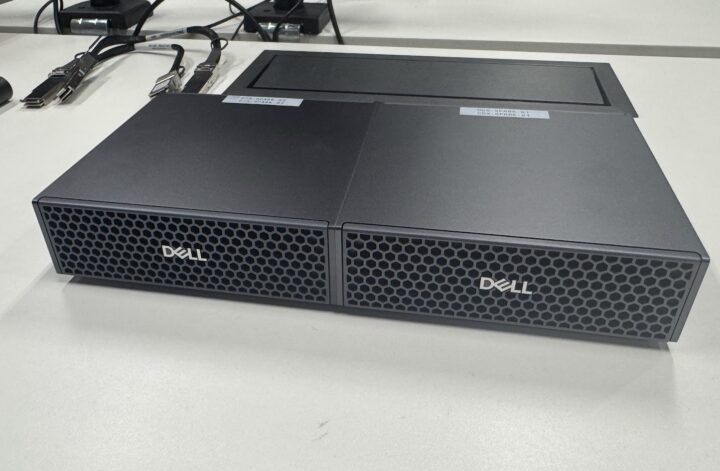
Dell Pro Max GB10: aparência despretensiosa, um supercomputador de IA por dentro.
Deixa eu começar pelo problema, como sempre gosto de fazer.
O jogo virou: você não contrata mais infra, você aluga tokens
Durante quinze anos a conta era simples. Você queria capacidade? Comprava servidor, dimensionava CPU, memória, storage. A dor era CAPEX. Hoje, quando uma empresa quer colocar IA pra dentro, a pergunta mudou. Ninguém pergunta “quantos núcleos eu preciso”. A pergunta virou “quantos tokens por mês eu vou queimar?”.
E aqui mora a armadilha. Token é o novo aluguel. É bonito no começo, você não compra nada, sobe uma API, paga pelo uso. Mas todo mundo que já passou por isso sabe: o modelo de “pague pelo uso” é maravilhoso até o uso virar rotina. Aí a fatura da OpenAI, da Anthropic ou do provedor da vez começa a subir de forma silenciosa e mensal, igual assinatura de streaming que você esqueceu de cancelar, só que com três zeros a mais.
Gosto de pensar que a IA repetiu o mesmo ciclo da nuvem: primeiro todo mundo migra encantado com o “sem servidor pra gerenciar”, e uns anos depois começa o movimento de trazer carga de volta pra casa porque a conta não fechou. Token é OPEX puro. E OPEX que cresce sem teto é dívida técnica disfarçada de conveniência.
É nesse ponto que o GB10 entra na conversa.
O que é o Dell Pro Max GB10 (e por que ele não é “só mais um mini PC”)
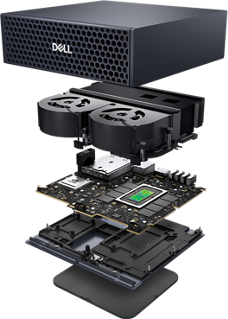
Por baixo do chassi: o NVIDIA GB10 Grace Blackwell Superchip.
Esqueça a aparência. Este tijolinho preto de aparência despretensiosa é, na prática, um supercomputador de IA de mesa. Por baixo do chassi ele carrega o NVIDIA GB10 Grace Blackwell Superchip, e os números fazem você repensar o que “desktop” significa:
- CPU Grace de 20 núcleos Arm (10 Cortex-X925 + 10 Cortex-A725)
- GPU Blackwell com 6.144 núcleos CUDA
- Até 1 PetaFLOP (1.000 TFLOPS) de desempenho em FP4
- 128 GB de memória unificada LPDDR5x CPU e GPU compartilhando o mesmo pool, sem cópia de dados de um lado pro outro
- 273 GB/s de banda de memória
- SSD Gen5 de 4 TB
- NIC ConnectX-7 com par de portas QSFP para 200 Gbit de rede
- Vem com o NVIDIA DGX OS já pronto, drivers, CUDA e frameworks (PyTorch, TensorFlow) pré-configurados
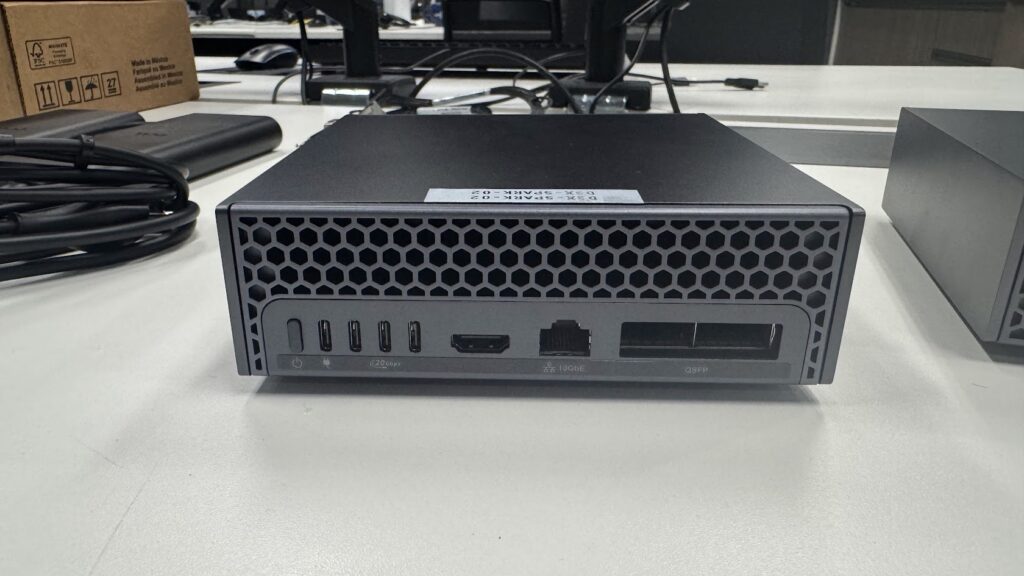
Conectividade: 4x USB-C 20Gbps, HDMI, 10GbE e o par de portas QSFP de 200 Gbit.
Traduzindo o número que mais importa: 128 GB de memória unificada é o que muda tudo. Numa GPU de jogo tradicional, você esbarra nos 12, 16, 24 GB de VRAM e o modelo simplesmente não cabe. Aqui, CPU e GPU bebem da mesma fonte de 128 GB. É por isso que esse aparelhinho aguenta modelos de até 200 bilhões de parâmetros rodando localmente, se você juntar duas unidades pelas portas QSFP, chega a modelos ainda maiores.
O teste: Llama de 8 bilhões de parâmetros, sem tocar na nuvem
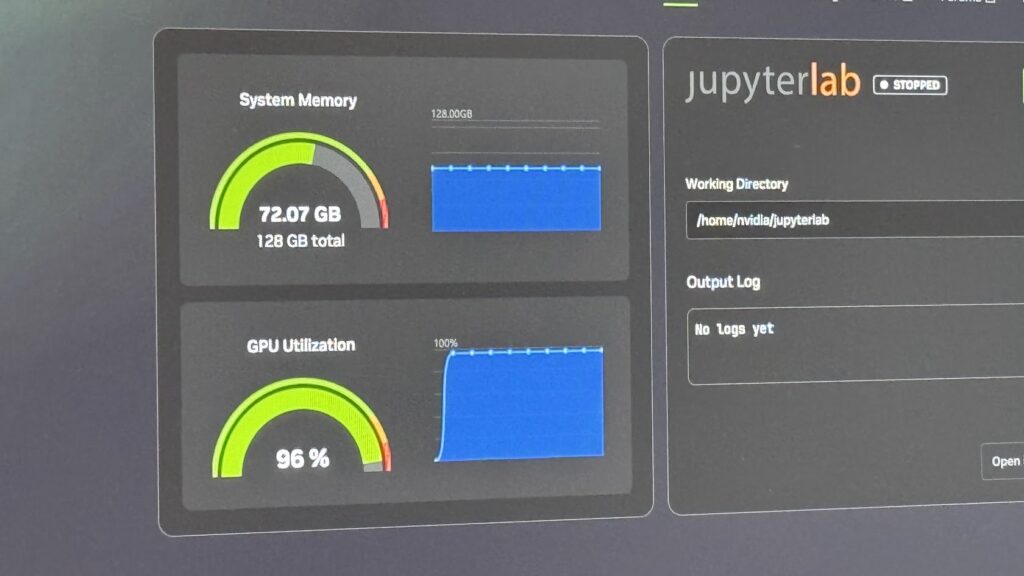
72 GB de memória em uso, GPU cravada em 96%: o hardware sendo realmente exigido.
Foi aqui que a ficha caiu de vez.
Eu não fui o piloto dessa vez, acompanhei dois amigos entusiastas colocando a mão na massa: um DevOps (Jardel) e um Tech Leader (Douglas). E confesso que aprender vendo gente boa operar às vezes rende mais do que fazer sozinho. Eles subiram um Llama de 8 bilhões de parâmetros local, sem depender de nenhuma API externa, e colocaram pra trabalhar.
O painel conta a história sozinho: 72 GB de memória em uso, GPU cravada em 96%. Ou seja, o hardware estava sendo realmente exigido, e ainda sobrava folga na memória pra crescer.
Pare pra pensar no que isso representa na prática:
- Zero tokens gastos. Cada inferência que roda ali é uma inferência que não apareceu na fatura da nuvem.
- Zero dado saindo de casa. Prompt, documento, informação de cliente, nada trafega pra fora. Pra quem lida com LGPD, jurídico ou saúde, isso sozinho já justifica o investimento.
- Latência previsível. Sem depender de fila de API, sem rate limit, sem “modelo indisponível no momento”.
Um Llama de 8B como esse dá conta com sobra de RAG, sumarização, extração de dados, chatbot interno, classificação, apoio a código. É exatamente o feijão com arroz da IA corporativa, e é justamente essa carga repetitiva e de alto volume que mais dói na conta de tokens quando roda na nuvem.
A conta que ninguém faz: CAPEX de uma vez contra OPEX pra sempre
Um aparelho desses custa, arredondando, algo na casa dos US$ 4 mil, uma vez. Compare com o que uma equipe de desenvolvimento ou um produto interno queima em tokens de API rodando dia e noite. Em muitos cenários que já vi, o equipamento se paga em meses, não em anos. Dali pra frente, cada inferência é praticamente de graça, você já pagou pelo hardware.
É a mesma lógica de sempre, só que aplicada a um mundo novo: infraestrutura própria é um custo que você amortiza; token de nuvem é uma torneira que nunca fecha. Não estou dizendo pra abandonar a nuvem, estou dizendo pra parar de usar a Ferrari da API premium pra buscar pão na padaria. A carga de trabalho pesada, sensível e repetitiva desce pra casa. A nuvem fica pro que é de fato eventual, gigante ou de fronteira.
Isso é FinOps aplicado à IA. E FinOps, no fim das contas, é só arquitetura com a calculadora na mão.
E não, isso não é brinquedo de mesa: já tem gente rackeando em datacenter
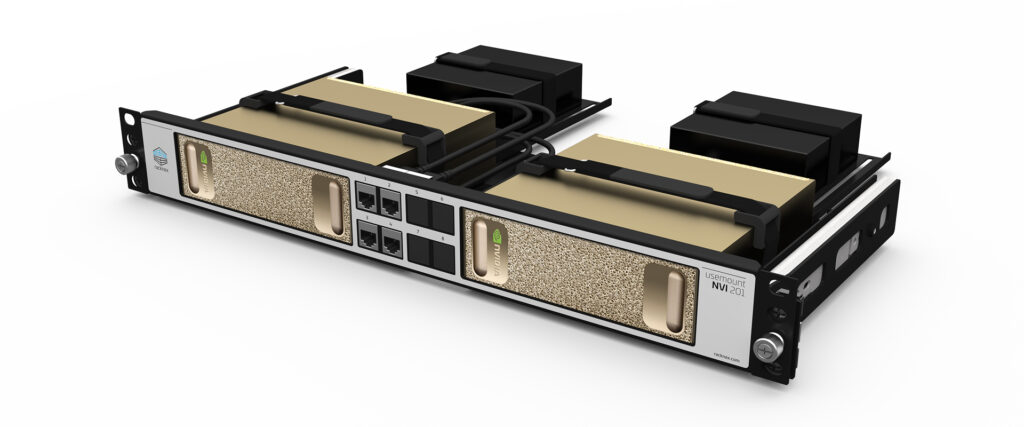
Esse foi o ponto que mais me surpreendeu na pesquisa.
Muita gente olha pra esse formato de “mini PC” e pensa em uso de mesa, de desenvolvedor. Mas as empresas já entenderam a jogada e estão colocando esses aparelhos dentro do datacenter. Como? Em gavetas (trays) específicas de rack. Já existem kits homologados de rackmount que acomodam duas unidades GB10 em pouco mais de 1U de um rack padrão de 19”, com as portas roteadas pra frente e tudo organizado, e esses kits suportam explicitamente o Dell Pro Max com GB10, além dos equivalentes de Acer, ASUS, GIGABYTE e Lenovo que usam o mesmo superchip.
Ou seja: o que começa como “um teste na mesa de dois amigos” vira, sem drama nenhum, uma fileira de nós de inferência empilhados no rack, cada um servindo seus modelos locais, interligados pelas portas QSFP de 200 Gbit. É um jeito completamente novo de montar capacidade de IA, modular, denso, energeticamente eficiente (o conjunto todo vive de uma fonte USB-C de ~280W) e, principalmente, sem uma fatura de tokens crescendo no fim do mês.
O que eu levo desse teste
O GB10 não vai substituir a nuvem, e nem é essa a proposta. O que ele faz é te devolver uma escolha que a IA-como-serviço tinha tirado da mesa: decidir o que roda dentro de casa e o que vale a pena alugar.
E essa escolha é, no fundo, uma decisão de arquitetura, não de hardware. Quem trata IA só como “assinar uma API” vai descobrir, lá na frente, que terceirizou junto o controle do próprio custo. Quem senta, dimensiona e decide onde cada carga deve viver, continua no comando.
Porque no fim, seja em virtualização, em nuvem ou em IA, o princípio não muda:
A tecnologia mudou o vilão da conta. Mas quem manda na conta continua sendo a arquitetura.
Ficou curioso pra saber se faz sentido trazer inferência pra dentro da sua operação? Me procure — adoro discutir esse tipo de conta.