EUA exigem licença para exportar chips avançados de IA ao Brasil: o que muda?
Na segunda-feira, 16 de novembro, o Bureau of Industry and Security (BIS), o braço do Departamento de Comércio dos Estados Unidos que cuida de controle de exportação, divulgou uma regra que mexe direto com quem trabalha com datacenter e IA por aqui. A partir de agora, pra um chip avançado de IA chegar ao Brasil, alguém precisa pedir licença ao governo americano.
Não estamos sozinhos. Indonésia, Malásia, Singapura e Tailândia entraram na mesma lista. O alvo declarado é a China, e os cinco países foram classificados como destinos com “risco de desvio acima do normal”. A regra vale a partir da publicação oficial, prevista pra 19 de novembro, e fica 60 dias aberta a comentários.
Vale um contexto. Em janeiro de 2025, a regra do governo Biden (a AI Diffusion Rule) já tinha colocado o Brasil num grupo intermediário, com cotas. Ela nunca foi aplicada e foi formalmente revogada agora, no mesmo documento. Saiu o modelo de cotas por país, entrou a licença caso a caso.
Lendo as 117 páginas pra separar o que está escrito do que é manchete. Vamos ao que realmente importa.
Não é proibição. Mas também não é carimbo
Ninguém proibiu a venda de GPU pro Brasil. O que mudou é que existe uma autorização no meio do caminho.
É tipo visto americano. Você não está proibido de entrar, mas pega fila e mostra documento. E quem tem passaporte americano passa direto: se o destinatário ou o usuário final tem sede nos EUA, ou controladora final lá, não precisa de licença. Basta o exportador mandar um relatório mensal ao BIS.
Tem um detalhe no texto que pouca gente comentou. Pra outro grupo de países, a regra escreve com todas as letras “presunção de aprovação”. Pros cinco, ficou só o caso a caso, e o critério citado é a eficácia do controle de exportação do país de destino e a cooperação dele com o BIS. Ou seja: parte da resposta depende de Brasília, não do seu projeto.
Como os EUA decidem o que é “chip avançado”
A regra não cita marca nem modelo. Ela usa uma métrica chamada TPP (Total Processing Performance), e a conta é mais simples do que parece: o desempenho de pico da ficha técnica, em TFLOPS, multiplicado pelo tamanho da operação em bits.
A linha de corte é 4.800. Pega uma NVIDIA A100: 312 TFLOPS em 16 bits. 312 × 16 = 4.992. Passou por pouco, e eu duvido que seja coincidência. Uma H100, pelas minhas contas com a mesma fórmula, fica na casa de 16 mil.
Chips abaixo disso também entram, a partir de 1.600, se concentrarem muito desempenho em pouca área de silício.
Três pontos pra não errar :
- Não é só GPU. O texto inclui TPUs, FPGAs, ASICs e qualquer acelerador que bata os parâmetros.
- Não é toda GPU. Chip que não foi feito pra datacenter e fica abaixo de 4.800 está fora.
- O servidor herda a classificação do chip. Basta um acelerador controlado dentro do chassi pro equipamento inteiro entrar na regra.
Sobre modelos: em 2023 a NVIDIA informou à SEC que A100, H100, L40, L40S e até a RTX 4090 estavam enquadradas. As gerações seguintes entregam mais, então a tendência é a mesma. Mas quem confirma a classificação de cada SKU é o fabricante, não eu.
Fabricado em Taiwan, montado no Brasil: tanto faz
Se o chip foi feito com tecnologia americana, a regra acompanha ele aonde for. O BIS usa exatamente esse exemplo: o chip incorporado a uma placa ou a um servidor produzido em outro país continua sob jurisdição americana.
E vale pra circulação dentro do Brasil. Revender um servidor com GPU controlada de uma empresa pra outra é uma “transferência dentro do país” e também pede licença. Inclusive equipamento usado.
O que muda na prática
Quem pede a licença é quem movimenta o equipamento: fabricante, distribuidor ou integrador. O comprador não preenche formulário, mas vai ter que informar quem é, quem controla a empresa, onde o equipamento vai ficar e quem vai usar.
Pra quem compra servidor com GPU, dá pra continuar comprando de Dell, HPE, Lenovo ou Supermicro. Só que a regra não define prazo de análise. Eu apostaria em entrega mais demorada e custo de compliance embutido no preço.
Pra quem tem pedido em andamento, a transição é curta. Só carga que já estava embarcada na data da publicação segue pela regra antiga, e a entrega precisa ser concluída em 30 dias.
Pra quem opera datacenter, o projeto de IA ganhou uma etapa a mais. O rack pode estar pronto, energia e refrigeração entregues, e o hardware parado esperando papel.
Pra quem vende GPU como serviço, vem a segunda frente da regra. Um datacenter, em qualquer país, precisa de licença se entregar mais de 12 milhões de TPP a empresas com sede ou controladora na China, em outros países restritos ou em Macau. Fazendo a conta, isso dá algo como 750 GPUs da classe H100. Não é número de hyperscaler, é um cluster de treinamento. E datacenters interligados somam, então dividir a carga entre sites não resolve.
Na prática, o provedor passa a ter obrigação de KYC (know your customer): saber quem é o cliente e quem está por trás dele. Se não conseguir comprovar isso pro fornecedor, a regra trata como sinal de alerta e a venda trava. Quem já presta esse tipo de serviço tem 90 dias pra se regularizar.
A conta que não fecha pro provedor nacional
A nuvem de capital americano que opera no Brasil entra pela exceção, com relatório mensal. O provedor brasileiro vai pra fila. A ABES chamou isso de “assimetria competitiva”, e eu concordo.
O próprio BIS, na estimativa de carga burocrática da regra, projeta cerca de 100 pedidos de licença a mais por ano, somando tudo. Pra cinco países, é muito pouco. Eles esperam que o grosso do volume passe pelas empresas americanas.
Do lado de cá, o MDIC disse, em nota reproduzida pela imprensa, que as exportações não foram proibidas e que ainda não dá pra medir o efeito.
O que eu faria agora
- Pediria ao fabricante, por escrito, a classificação de exportação e o TPP de cada item do projeto.
- Colocaria folga de prazo em todo cronograma de IA.
- Deixaria pronta a documentação societária, até a controladora final.
- Se vendesse capacidade de GPU, revisaria o cadastro e o contrato dos clientes.
Considerações
Durante anos, a pergunta num projeto de datacenter era “tem energia?” e “tem espaço?”. Agora entrou mais uma: “esse hardware chega quando?”. E a resposta não depende mais só do fabricante.
O que me preocupa é o sinal. O Brasil vem se vendendo como destino de datacenter de IA, com energia limpa e incentivo fiscal. O selo de “risco de desvio” atrapalha essa conversa, e isso não se resolve com engenharia. Resolve com diplomacia e com um controle de exportação que Washington reconheça.
Pra quem opera, nem pânico, nem descaso. Quem estiver com a classificação e a documentação em ordem vai receber hardware antes do concorrente.
Até a próxima, pessoal!
DCD Connect 2026 e The Xcelerated Compute Show
Nos dias 4 e 5 de novembro, estive no Sheraton WTC, em São Paulo, acompanhando o DCD Connect Brasil 2026 e o The Xcelerated Compute Show. Foram dois dias de discussões sobre energia, infraestrutura para inteligência artificial, refrigeração e novos modelos de negócio para o setor.
O evento reuniu mais de 3,2 mil participantes, 170 palestrantes e 160 expositores. Além dos painéis tradicionais do DCD Connect, a programação contou com o Investment Forum e um espaço dedicado à computação acelerada, com a NVIDIA como lead partner.
Energia: o principal gargalo da IA
Um dos debates mais relevantes foi direto ao ponto: sem energia não há IA. Um dado apresentado durante o painel chamou atenção: a construção de um grande data center pode levar de 2 a 4 anos, enquanto a expansão da infraestrutura elétrica necessária pode levar de 6 a 8 anos.
Os pedidos de conexão, antes na faixa de 10 ou 20 MW, já chegam a 200 MW, e há projetos discutindo demandas de até 1 GW. Ou seja, o desafio não está apenas em comprar GPUs: é preciso conseguir energia para mantê-las operando.
A Ascenty apresentou o exemplo de Sumaré, onde investiu cerca de R$ 200 milhões em uma linha própria de 35 km para conectar seu campus a uma subestação. A discussão sobre permitir maior participação dos operadores na construção da infraestrutura elétrica merece atenção.
Outro ponto interessante foi a possibilidade de utilizar baterias, UPS e geradores dos data centers como recursos de flexibilidade para a rede elétrica, ajudando a reduzir picos de consumo. Se houver evolução regulatória, ativos que hoje ficam grande parte do tempo em espera poderão ter um papel adicional.
Também ficou claro que nem toda carga de IA precisa estar perto dos grandes centros consumidores. Treinamento e determinadas aplicações de inferência podem operar em regiões com energia e conectividade disponíveis. Isso abre espaço para novos polos fora do eixo Rio–São Paulo.
O mapa dos investimentos: Ceará em destaque
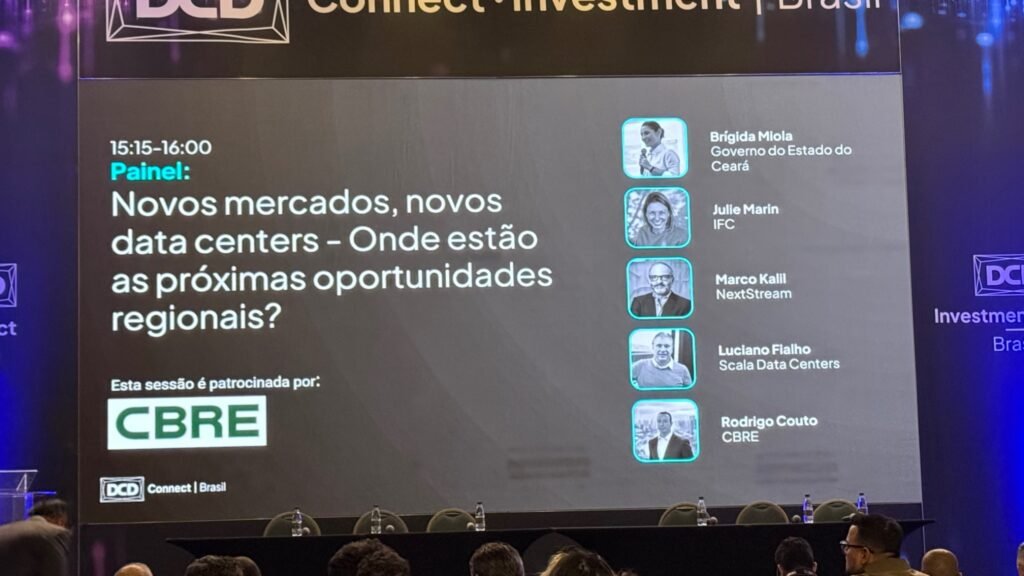
O painel “Novos mercados, novos data centers” reuniu representantes do Governo do Ceará, IFC, NextStream, Scala Data Centers e CBRE. A presença do Ceará na discussão não foi por acaso: o estado combina disponibilidade energética, conectividade internacional e projetos relevantes de infraestrutura digital, especialmente na região do Pecém.
Uma ausência que me chamou atenção foi Santa Catarina. Temos operadores, conectividade e uma posição interessante no Sul do país, mas ainda precisamos avançar para entrar com mais força nesse mapa de investimentos. Vejo nisso um desafio, mas também uma oportunidade.
Cooling: não existe uma solução única
Com o aumento da densidade das GPUs, a refrigeração deixou de ser um detalhe de projeto. Entre as alternativas discutidas, três tecnologias se destacam:
- Rear Door Heat Exchanger (RDHx): trocador de calor na porta traseira do rack. Pode ser um caminho para ampliar a densidade em salas existentes, sem uma reforma completa.
- Direct-to-Chip: líquido circula por cold plates instaladas diretamente nos componentes, como CPUs e GPUs. É indicado para ambientes de alta densidade e HPC.
- Immersion Cooling: servidores submersos em fluido dielétrico. É uma alternativa para cenários de densidade e exigência térmica extremas.
Como referência, a refrigeração a ar costuma atender racks na faixa de 10 a 15 kW, enquanto soluções líquidas podem chegar a densidades próximas de 100 kW por rack, conforme a arquitetura. Para quem já opera salas convencionais, a porta traseira pode ser um passo intermediário antes de partir para soluções mais complexas.
AI Factory por assinatura
No The Xcelerated Compute Show, a Positivo apresentou a linha IA Box, baseada no modelo Hardware as a Service (HaaS): em vez de comprar toda a infraestrutura, o cliente contrata uma mensalidade e mantém o equipamento em seu próprio ambiente.
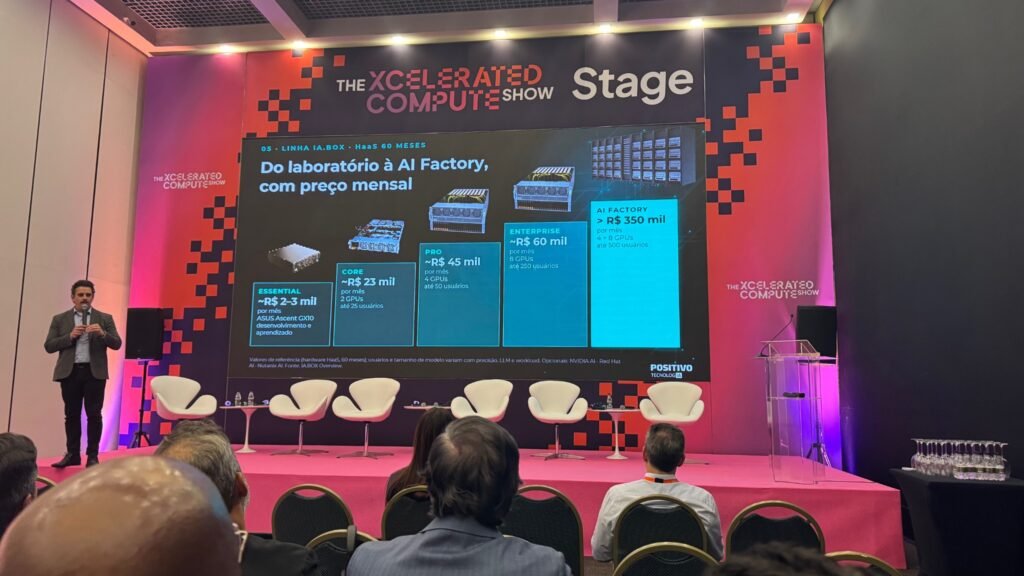
Os valores de referência exibidos no evento, para contratos de 60 meses, foram:
- Essential: R$ 2 mil a R$ 3 mil/mês, com ASUS Ascent GX10.
- Core: cerca de R$ 23 mil/mês, 2 GPUs e até 25 usuários.
- Pro: cerca de R$ 45 mil/mês, 4 GPUs e até 50 usuários.
- Enterprise: cerca de R$ 60 mil/mês, 6 GPUs e até 250 usuários.
- AI Factory: acima de R$ 350 mil/mês, com 4 ou mais GPUs e até 500 usuários.
A proposta chama atenção por ocupar um espaço entre consumir IA por APIs de hyperscalers e investir milhões em um cluster próprio. Para empresas que precisam manter dados e processamento sob seu controle, mas preferem evitar um CAPEX elevado, esse modelo pode fazer sentido.
Cloud, on-premise e o modelo híbrido
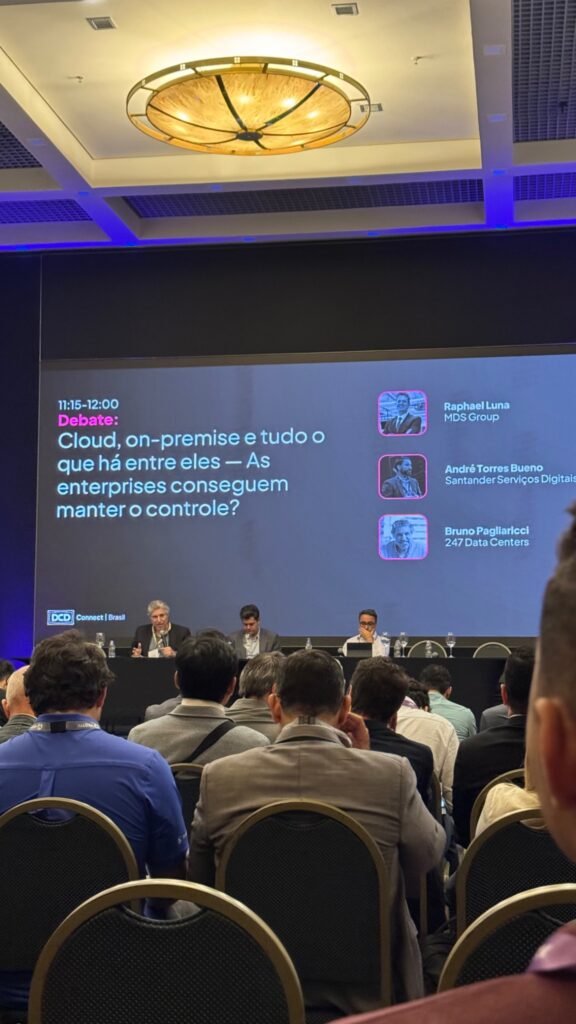
Outro debate abordou como as empresas podem manter o controle em ambientes que combinam cloud pública, infraestrutura própria e modelos híbridos.
Na prática, a decisão não deveria ser simplesmente cloud ou on-premise. Cada workload precisa estar no ambiente mais adequado, considerando custo, desempenho, segurança, latência, disponibilidade e requisitos regulatórios. O desafio é manter governança e visibilidade sobre toda essa operação.
O que fica do DCD Connect 2026
Minha principal impressão é que a expansão da inteligência artificial está trazendo o debate de volta aos fundamentos da infraestrutura. Antes de falar em grandes clusters, precisamos resolver energia, refrigeração, conectividade e capacidade física.
Três pontos resumem o que levo do evento:
- Energia é estratégica: precisa entrar no planejamento desde o início, pois pode definir onde e quando um data center será viável.
- Cooling precisa acompanhar a densidade: a tecnologia deve ser escolhida conforme o workload, a infraestrutura existente e o TCO.
- IA como serviço abre novas oportunidades: existe mercado entre a API de terceiros e o investimento em infraestrutura própria.
Estamos entrando em uma nova fase para os data centers. A inteligência artificial não muda apenas os servidores: muda o planejamento de energia, refrigeração, conectividade, armazenamento e os próprios modelos de negócio.
O Brasil tem potencial para ocupar um espaço importante nessa transformação. A questão é se conseguiremos transformar esse potencial em infraestrutura digital, com energia e capacidade disponíveis onde o mercado precisa.
Até o próximo evento, pessoal!
IBM TechXchange 2026 – Atlanta
Se o VMware Explore foi a Broadcom tentando fazer as pazes com o cliente, o IBM TechXchange 2026 foi a IBM tentando colocar limites em agente de IA. Passei a semana de 26 a 29 de outubro em Atlanta, no Georgia World Congress Center, e o recado do evento inteiro cabe numa frase do keynote de abertura do Dinesh Nirmal (SVP de Software da IBM): só uns 25% dos agentes de IA hoje estão prontos pra rodar em empresa. Os outros 75% são prompt solto com acesso a sistema de produção.
O TechXchange é o evento técnico da IBM (o Think é o executivo; esse aqui é o de quem bota a mão na stack). Mais de 5,4 mil pessoas de 76 países, mais de mil sessões, e uma novidade de formato: a HashiConf rodou dentro do TechXchange. Isso explica por que Terraform e Vault apareceram em quase toda conversa.
Agente sem dono não entra: Agent Identity e Vault 2.2
O anúncio que amarra o evento inteiro é o IBM Agent Identity, no dia 26, junto com o HashiCorp Vault 2.2. A ideia é simples de explicar e difícil de fazer: todo agente vira uma identidade com dono, inventário e missão, recebe credencial efêmera (token de curta duração, escopo por tarefa) e pode ter a sessão revogada em tempo real. Tentou fazer algo fora da permissão, a sessão cai na hora. O Vault emite a credencial just-in-time, e tudo fica numa trilha de auditoria ligando humano, agente e ação.
É o crachá de visitante que expira no fim do dia, só que pra software. Hoje a maioria das empresas dá ao agente o crachá do diretor e torce.
watsonx Orchestrate quer ser o controle, não a fábrica
A segunda peça é o watsonx Orchestrate, que ganhou um AI Gateway único pra descobrir, conter e avaliar agentes, inclusive os que não são da IBM: Amazon Bedrock, Microsoft Foundry e Google Gemini. Discover e Contain (sandbox isolado com kill switch) estão em tech preview; Evaluate já está disponível, com LLM-as-a-judge e trace passo a passo do que o agente fez. Tem ainda um Premium Runtime com isolamento por hardware.
A IBM entendeu que não vai ganhar a corrida de quem constrói o melhor agente. Então está se posicionando como a camada de governança por cima dos agentes dos outros. É middleware, de novo. Coerente com o histórico deles.
Concert: Instana, Turbonomic, SevOne e AIOps numa coisa só
Pra quem é de operação, o anúncio mais prático foi o IBM Concert virando plataforma unificada: observabilidade full-stack (Instana), observabilidade de rede (SevOne), otimização de capacidade (Turbonomic), gestão de incidentes (o antigo Cloud Pak for AIOps) e vulnerabilidades com prova de exploitabilidade. Roda em SaaS ou on-prem, e podemos definir o que automatiza e o que precisa de aprovação.
Para operadora, correlação app + infra + rede num lugar só é exatamente a dor que a gente vive no NOC: o alarme nasce na rede, aparece na aplicação e o ticket cai na infra. Vale PoC.
HashiConf dentro do TechXchange: Terraform pra agentes
Com a HashiConf integrada, o Terraform teve sua própria rodada de anúncios. O Terraform policy (policy-as-code em HCL, com conversor pra quem vem de Sentinel e OPA) . O Developer Portal (self-service governado: o time de plataforma define o padrão, dev e agente consomem) e o servidor MCP remoto do HCP Terraform estão em public preview.
A lógica: um agente (citaram IBM Bob, Claude Code, Copilot e Cursor) descobre módulos aprovados e gera código no padrão da empresa, com a mesma autenticação e as mesmas permissões de um humano. Traduzindo: o agente não ganha atalho. Entra pela mesma porta que você.
Supply chain open source: Bob DevSecOps e a Lightwell
O IBM Bob, o agente de desenvolvimento da IBM (já com 170 mil usuários, dois terços deles não desenvolvedores), ganhou um pacote premium de DevSecOps. O recurso que mais me chamou atenção é o SafeWrite: ele intercepta a edição de arquivo ou a instalação de pacote que o agente de IA propôs, antes de chegar no disco, e troca a dependência vulnerável pela versão corrigida mais próxima. Se não tem correção conhecida, bloqueia. Além disso, SAST em tempo real e review de pull request, que chega em novembro pra GitHub.
Nas sessões da Red Hat, o assunto dominante foi a Lightwell, a iniciativa IBM + Red Hat anunciada em maio com US$ 5 bilhões e 20 mil engenheiros pra remediar vulnerabilidade em open source com IA. Em outubro divulgaram mais de 400 vulnerabilidades inéditas corrigidas em bibliotecas Java; a promessa no título das sessões era patch de 90 pra 7 dias. A fase comercial começou por financeiro; telecom está na lista de expansão. Vou acompanhar.
Pós-quântico saiu do PowerPoint
O IBM Quantum Safe virou uma suíte de verdade: Cryptography Manager (inventário e migração), Explorer (varre o código e gera CBOM, o “bill of materials” criptográfico) e Proxy (deixa cliente legado conviver com servidor já pós-quântico). Os prazos regulatórios que eles citaram começam em 2030, e o argumento do “harvest now, decrypt later” vale pra qualquer dado que precisa ficar sigiloso por mais de cinco anos. Certificado, VPN e dado de assinante entram nessa conta.
Se você ainda não tem inventário criptográfico, 2027 é um bom ano pra começar. Não porque o quântico chega em 2027, mas porque inventário de certificado em empresa grande demora mais do que a gente admite.
E a infraestrutura? Evolução, sem lançamento
Vou ser direto: não teve anúncio novo de Power nem de Storage nessa edição. O Power11 é de julho de 2025 e a família FlashSystem 5600/7600/9600 saiu em fevereiro. O que teve foi evolução em volta do que já existe:
- Spyre, o acelerador de IA da IBM, agora roda modelos do Hugging Face e vLLM via integração profunda com PyTorch (anúncio de 17/10, reforçado no evento). Pra inferência em Power sem GPU, começa a ficar interessante.
- OpenShift Virtualization teve deep dive de storage (CSI, storage class pra VM, live migration, snapshot, clone, HA e DR). Pra quem avalia uma segunda plataforma de virtualização depois do licenciamento da Broadcom, é sinal de maturidade.
- IBM Fusion com OpenShift apareceu no user group da Red Hat, junto com o caso interno da própria IBM (“Client Zero”).
- Inferência distribuída com llm-d e vLLM, e um lab de “Model-as-a-Service” privado com controle de acesso e métrica de uso pra chargeback. Pra quem entrega cloud pra cliente, como a gente, isso é produto pronto pra copiar.
- Instana + Event-Driven Ansible + agentes via MCP fechando o loop de AIOps, com RBAC e aprovação humana antes de executar a remediação.
Resumo do TechXchange 2026
A IBM deslocou o centro de gravidade de “modelo” pra “agente governado” e reorganizou o portfólio inteiro (Orchestrate, Concert, Verify, Vault, Terraform) em torno de três palavras: identidade, controle e operação. Pra quem roda infraestrutura e cloud, o que importa não é a fábrica de agentes. É a camada de baixo: segredo, política, observabilidade e plataforma Kubernetes/virtualização. IBM e Red Hat estão tratando isso como pré-requisito, e eu concordo.
E a parte boa é que quase tudo que vi dá pra experimentar em escala pequena antes de qualquer compromisso: Vault pra credencial efêmera, policy-as-code no Terraform, um PoC de Concert num domínio só, um cluster de OpenShift Virtualization. Arquitetura primeiro, contrato depois. É por aí que eu começaria.
Se você só tem tempo pra acompanhar uma coisa desse evento, é o Agent Identity. O resto orbita em volta dele.
O TechXchange 2027 já tem data: 8 a 11 de novembro de 2027, de novo em Atlanta. Até o próximo evento, pessoal!
VMware Explore 2026: a semana que vai definir o próximo ciclo da nuvem privada com IA
Não é exagero dizer que o VMware Explore 2026, que começa nesta segunda-feira (31/08) em Las Vegas, chega num momento de virada para quem trabalha com infraestrutura, cloud e IA corporativa. E eu vou acompanhar tudo de perto, direto do Venetian Convention Center.
O motivo do hype não é só marketing de evento. Em maio deste ano, a Broadcom lançou o VMware Cloud Foundation 9.1, e os números que a empresa divulgou são do tipo que faz qualquer gestor de TI parar pra prestar atenção: até 40% de redução no custo de servidores, 39% menos custo total de armazenamento, 46% menos custo operacional de Kubernetes e upgrades de cluster até 4 vezes mais rápidos. Tudo isso mirando um problema específico: rodar cargas de IA em produção sem estourar orçamento nem abrir mão de segurança.
E aqui está o dado que muda a conversa: segundo o relatório Private Cloud Outlook 2026 da própria Broadcom, 56% das organizações já rodam ou planejam rodar inferência de IA em produção dentro de nuvem privada, uma categoria que nem existia na pesquisa do ano passado. O discurso de “tudo na nuvem pública” está sendo reescrito na prática, puxado por custo, soberania de dados e controle sobre modelos proprietários.
O que abre a semana
O keynote de segunda-feira, às 9h (horário de Vegas), já dá o tom: “Shaping the Future of Private AI Cloud and Agentic Innovation”, com Ram Velaga (Presidente do Infrastructure Software Group da Broadcom), Paul Turner (Chief Product Officer da divisão VMware Cloud Foundation) e um nome que chama atenção, Hemant Rijhumal, do Standard Chartered Bank, falando sobre como um banco global estrutura nuvem privada em escala real.
Os quatro temas que vão dominar a semana
Private AI Cloud e IA agêntica. O que eu considero um dos tópicos CORE do evento. A pergunta que todo mundo está fazendo: como colocar modelos de IA para rodar em produção, com segurança e sem depender 100% de hyperscaler.
A “crise de hardware de 2026”. GPU escasso, prazos de entrega esticados. Uma das sessões do evento é literalmente sobre como “sobreviver” a esse cenário otimizando o que já se tem de infraestrutura.
FinOps e Tokenomics. Com IA generativa e agentes consumindo tokens em escala, o controle de custo virou disciplina própria. Vai ter sessão dedicada a gestão de ROI e ao que estão chamando de “tokenomics” da era da IA.
Soberania de dados (Sovereign Cloud). Tema que ganhou força com regulação e geopolítica, e que vai aparecer em pelo menos uma sessão dedicada só a isso.
Além dos keynotes e das mais de 400 sessões técnicas, o evento tem Command Center Wall (monitoramento de implantações VCF em tempo real), hands-on labs e cinco certificações VCAP disponíveis para quem quiser sair de Vegas com currículo atualizado.
Nos próximos dias, vou publicar a cobertura dia a dia direto daqui, sessões, bastidores e o que realmente importa pra quem decide infraestrutura no Brasil. Acompanha comigo.