VMware Explore 2026: a semana que vai definir o próximo ciclo da nuvem privada com IA
Não é exagero dizer que o VMware Explore 2026, que começa nesta segunda-feira (31/08) em Las Vegas, chega num momento de virada para quem trabalha com infraestrutura, cloud e IA corporativa. E eu vou acompanhar tudo de perto, direto do Venetian Convention Center.
O motivo do hype não é só marketing de evento. Em maio deste ano, a Broadcom lançou o VMware Cloud Foundation 9.1, e os números que a empresa divulgou são do tipo que faz qualquer gestor de TI parar pra prestar atenção: até 40% de redução no custo de servidores, 39% menos custo total de armazenamento, 46% menos custo operacional de Kubernetes e upgrades de cluster até 4 vezes mais rápidos. Tudo isso mirando um problema específico: rodar cargas de IA em produção sem estourar orçamento nem abrir mão de segurança.
E aqui está o dado que muda a conversa: segundo o relatório Private Cloud Outlook 2026 da própria Broadcom, 56% das organizações já rodam ou planejam rodar inferência de IA em produção dentro de nuvem privada, uma categoria que nem existia na pesquisa do ano passado. O discurso de “tudo na nuvem pública” está sendo reescrito na prática, puxado por custo, soberania de dados e controle sobre modelos proprietários.
O que abre a semana
O keynote de segunda-feira, às 9h (horário de Vegas), já dá o tom: “Shaping the Future of Private AI Cloud and Agentic Innovation”, com Ram Velaga (Presidente do Infrastructure Software Group da Broadcom), Paul Turner (Chief Product Officer da divisão VMware Cloud Foundation) e um nome que chama atenção, Hemant Rijhumal, do Standard Chartered Bank, falando sobre como um banco global estrutura nuvem privada em escala real.
Os quatro temas que vão dominar a semana
Private AI Cloud e IA agêntica. O que eu considero um dos tópicos CORE do evento. A pergunta que todo mundo está fazendo: como colocar modelos de IA para rodar em produção, com segurança e sem depender 100% de hyperscaler.
A “crise de hardware de 2026”. GPU escasso, prazos de entrega esticados. Uma das sessões do evento é literalmente sobre como “sobreviver” a esse cenário otimizando o que já se tem de infraestrutura.
FinOps e Tokenomics. Com IA generativa e agentes consumindo tokens em escala, o controle de custo virou disciplina própria. Vai ter sessão dedicada a gestão de ROI e ao que estão chamando de “tokenomics” da era da IA.
Soberania de dados (Sovereign Cloud). Tema que ganhou força com regulação e geopolítica, e que vai aparecer em pelo menos uma sessão dedicada só a isso.
Além dos keynotes e das mais de 400 sessões técnicas, o evento tem Command Center Wall (monitoramento de implantações VCF em tempo real), hands-on labs e cinco certificações VCAP disponíveis para quem quiser sair de Vegas com currículo atualizado.
Nos próximos dias, vou publicar a cobertura dia a dia direto daqui, sessões, bastidores e o que realmente importa pra quem decide infraestrutura no Brasil. Acompanha comigo.
Como dimensionar um ambiente de virtualização para crescer sem rework
Ambientes virtualizados raramente falham no momento da implantação.
Na maioria dos casos, eles entram em colapso meses depois, quando começam a crescer sem que o projeto inicial tenha considerado expansão, picos de consumo e cenários reais de falha.
O quase nunca é a tecnologia, mas sim o modelo mental utilizado no dimensionamento.
Neste artigo veremos um método prático para dimensionar ambientes de virtualização com foco em:
- Estabilidade operacional
- Crescimento previsível
- Facilidade de expansão
- Redução de retrabalho (rework)
Sem fórmulas mágicas, baseado em princípios de arquitetura.
Por que ambientes virtualizados quebram
Os principais fatores que levam um ambiente a degradação é:
- Projeto baseado apenas em capacidade bruta (TB e número de cores)
- Ignorar latência de storage
- Overcommit agressivo sem observabilidade
- Ausência de margem para alta disponibilidade
- Crescimento orgânico sem planejamento
Virtualização não morre por falta de hardware, virtualização morre por falta de arquitetura.
Definição do perfil de workload
Antes de falar em servidor, é obrigatório entender a carga.
Perguntas essenciais:
- Quantas VMs?
- Quantas VMs em 12,24 ou 60 meses?
- Aplicações são CPU-bound, memory-bound ou IO-bound?
- Há workloads sensíveis à latência?
Classificação simples:
- CPU-bound → bancos de dados, aplicações com alto cálculo
- Memory-bound → caches, aplicações Java, analytics
- IO-bound → VDI, bancos de dados transacionais, file servers
Dois ambientes com o mesmo número de VMs podem exigir arquiteturas completamente diferentes.
Dimensionamento de CPU
Princípios:
- vCPU não é core físico
- Overcommit é aceitável, desde que controlado
- Frequência de clock importa tanto quanto quantidade de núcleos
Boas práticas:
- Overcommit conservador: 3:1
- Reservar capacidade para falha de pelo menos um host
- Monitorar CPU Ready
Se o ambiente é crítico, priorize mais hosts médios ao invés de poucos hosts gigantes.
Dimensionamento de memória
Memória é o recurso mais crítico da virtualização.
Princípios:
- Evitar ballooning e swapping
- Considerar consumo do hypervisor
- Considerar cache de storage em memória
Boas práticas:
- Margem livre mínima: 20% a 30%
- Evitar overcommit agressivo
- Padronizar tamanhos de VM quando possível
Gosto de pensar que cpu se gerencia e memória se respeita.
Storage: latência primeiro, capacidade depois
Usuários não percebem IOPS.
Usuários percebem latência.
Aspectos fundamentais:
- Latência média
- Latência em pico
- Perfil de leitura vs escrita
- Aleatório vs sequencial
Boas práticas:
- Separar tiers (NVMe, SSD, NL-SAS)
- Garantir cache adequado
- Monitorar filas de IO
Rede dentro da virtualização
Rede subdimensionada mascara problemas de CPU e storage.
Boas práticas:
- Redundância física
- Separação lógica de tráfego
- Gerência
- Storage
- Migração
- Produção
- Throughput compatível com storage
Evite arquiteturas onde todo tráfego passa por um único uplink.
Alta disponibilidade na prática
Pergunta que deve ser pensanda, se eu perder um host agora, tudo continua funcionando?
Boas práticas:
- Capacidade reservada para falha
- Testes periódicos de HA
- Janela de manutenção considerada no projeto
Regra prática:
HA sem capacidade é apenas reinicialização elegante.
Planejamento de crescimento
Todo projeto deve nascer com:
- Slots livres de expansão
- Licenciamento previsto
Escalar não deve ser um projeto especial.
Deve ser rotina operacional.
Erros clássicos
- Comprar servidor maior em vez de mais nós
- Misturar workloads incompatíveis no mesmo cluster
- Não medir consumo real
- Ignorar latência
- Não testar cenários de falha
Meu pensamento
Muitas organizações investem em servidores de marcas enterprise, como Dell ou Lenovo, contratam 5, 6 ou até 7 anos de garantia e acreditam que isso, por si só, garante longevidade ao ambiente.
Na prática, vemos exatamente o oposto: clusters que morrem com 2 ou 3 anos, não por falha de hardware, mas por mau dimensionamento.
O hardware sobrevive. A arquitetura não.
Um cluster começa a envelhecer no dia em que nasce, e esse envelhecimento é acelerado quando:
- O dimensionamento de vCPU é feito sem critério
- Processadores são escolhidos apenas pela quantidade de cores, ignorando clock base
- Workloads single-threaded sofrem por falta de frequência
- A segmentação lógica de rede é tratada como “opcional”
Dimensionar corretamente vCPU, priorizar CPUs com frequência base mais alta para cargas sensíveis a single-thread e desenhar uma segmentação lógica bem definida (gerência, storage, migração e produção) devem ser decisões tomadas antes da primeira VM ser criada.
É curioso observar que muitas empresas consideram o cluster de virtualização como o ativo mais crítico do negócio, mas não executam sequer o básico — como configurar alta disponibilidade para o vCenter Server.
Sim, o coração do ambiente sem HA.
Se você quer evitar que seu cluster envelheça antes do tempo, o ponto de partida não é o modelo do servidor.
É o desenho.
Me procure para trocar uma ideia e desenhar juntos o melhor cenário.
Ambiente virtualizado bem projetado não é o maior.
Não é o mais caro.
Não é o mais novo.
É aquele que cresce sem surpresa, opera estável e permite expansão sem redesenho.
Arquitetura vem antes do hardware.
Por trás do Pandora — O cluster que não dorme
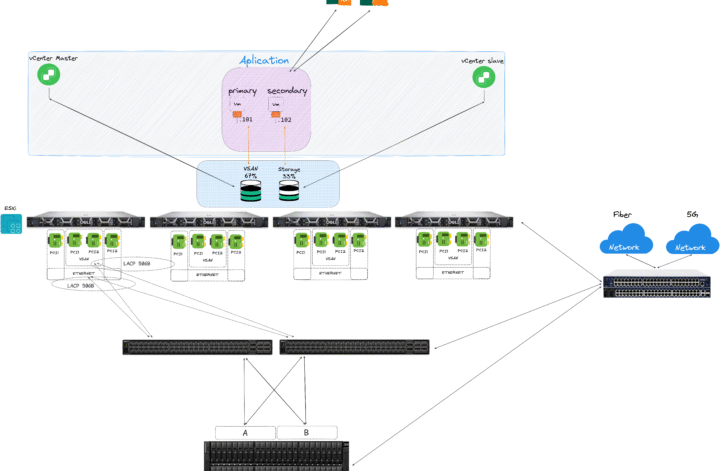
O Cluster Pandora nasceu dentro da Unifique Cloud com um propósito ousado: garantir que a gestão e os serviços críticos do ambiente permaneçam operacionais mesmo diante de falhas severas de storage, rede ou virtualização.
Mais do que um cluster de gerenciamento, o Pandora é um núcleo autônomo e distribuído de controle e orquestração, construído para operar de forma independente e manter a Unifique Cloud sob controle — mesmo quando o resto do ambiente para.
O Desafio
Em uma infraestrutura moderna, quase tudo depende da camada de gerenciamento.
Mas o time da Unifique Cloud percebeu um ponto cego:
“E se o próprio ambiente de controle cair junto com o restante da infraestrutura?”
A resposta foi criar um cluster isolado, resiliente e autossustentável, espalhado por locais físicos diferentes da infraestrutura principal, garantindo continuidade operacional e independência total.
Assim nasceu o Projeto Pandora — o cluster que não dorme.
A Arquitetura
O Pandora foi projetado sobre processadores AMD EPYC, que entregam alta densidade de núcleos, performance térmica eficiente e confiabilidade sob carga constante.
Seu armazenamento é 100% baseado em discos NVMe, garantindo latência ultrabaixa e throughput máximo, mesmo em cenários de operações simultâneas de backup, replicação e orquestração.
Cada host está conectado a todos os Top of Rack (ToR) do datacenter, com uplinks redundantes e um canal WAN exclusivo, permitindo acesso remoto e gestão plena mesmo em situações de isolamento da rede interna.
Além disso, o cluster é geograficamente distribuído, aumentando ainda mais sua tolerância a falhas físicas e elétricas.
O armazenamento roda sobre VMware vSAN configurado em RAID1, assegurando espelhamento de dados entre hosts.
E, indo além da replicação, os serviços foram intencionalmente distribuídos entre o vSAN e storages dedicadas — exemplo: quatro controladores de domínio (AD), sendo dois no vSAN e dois em storage independente.
Mesmo em uma falha total de um dos sistemas de armazenamento, os serviços de autenticação e diretório seguem em operação.
Serviços Críticos Hospedados
O Pandora é o ponto de sustentação da Unifique Cloud, abrigando não só a camada de gerenciamento, mas também serviços de produção utilizados por clientes.
Dentro dele rodam:
- vCenter, VMware Cloud e NSX Manager – o coração da virtualização e SDN.
- Veeam Backup & Replication – Backup Server incluindo o serviço de Cloud Connect entregue aos clientes Unifique.
- Active Directory e PAM – autenticação, segurança e controle de privilégios.
- Kubernetes Cluster e Load Balancer – orquestração e entrega de microsserviços internos.
- Soluções de monitoramento da Cloud – visibilidade completa da operação.
- Portais e dashboards das nuvens – interface de gestão e provisionamento.
- Sistemas de inventário, como o NextBox – controle de ativos e topologia.
Com esse desenho, o Pandora garante que, mesmo durante falhas severas em storages, leafs, spines ou clusters VMware, a gestão, o monitoramento e os serviços críticos continuem operando de forma independente.
O Pandora é um ambiente construído para não ser usado — como um seguro de carro: você espera nunca precisar, mas dorme tranquilo sabendo que está protegido.
Ele existe para garantir que, em um cenário de contingência total, a Unifique nunca fique no escuro.
Mesmo que o ambiente principal sofra interrupções graves, o Pandora mantém viva a inteligência e o comando da operação.
Resiliência Total
O projeto foi desenhado para resistir a falhas múltiplas e simultâneas:
- Falha de storage? Aplicações redundantes continuam disponíveis.
- Perda de leaf ou spine? Conectividade mantida pelos ToRs ativos.
- Clusters VMware fora do ar? O Pandora segue orquestrando o ambiente e coordenando a recuperação.
Os backups seguem a política 3-2-1, armazenados em storage dedicada e replicados para appliance S3 imutável, protegendo contra falhas físicas, humanas e lógicas.
Resultado
O Cluster Pandora consolidou-se como o núcleo de resiliência e governança distribuída da Unifique Cloud.
Mais do que um projeto técnico, ele representa uma filosofia de engenharia:
Alta disponibilidade não é um recurso. É uma mentalidade.
E quando o inesperado acontece, o Pandora está lá — garantindo que a Unifique siga no comando.
Evolução e Estratégia para VCF9: O que mudou e por que isso importa
Olá leitoires, muito se fale sobre versões, é importante destacar que não existe ESXi 9 — a nomenclatura mudou: a VMware passou a se referir à versão como vSphere 9, sem o “i”. Essa mudança de nome traz também ajustes na forma como os produtos são licenciados e implantados, especialmente para soluções de nuvem híbrida e infraestrutura moderna.
Principais diferenças estratégicas:
- vSphere 9 é a base do VCF9:
- O VMware Cloud Foundation 9 (VCF9) traz todo o ecossistema atualizado para gestão unificada de compute, storage e rede, com suporte nativo a vSAN, NSX-T e Tanzu.
- Isso simplifica a operação, automatiza o ciclo de vida e permite adoção mais rápida de ambientes híbridos e multi-cloud.
- Suporte a modernização de workloads:
- Integração completa com Kubernetes via Tanzu, facilitando a execução de containers junto de máquinas virtuais em um mesmo stack.
- Melhor performance para workloads críticos e aumento da eficiência de hardware.
- Licenciamento e Foundation:
- O vSphere 9, dentro do VCF9, é distribuído principalmente via vSphere Foundation, permitindo uma visão consolidada de todos os recursos e licenças.
- Atualizações e upgrades passam a ser mais automáticas, reduzindo risco operacional.
- Segurança e compliance:
- Hardening nativo, criptografia avançada e integração com VMware Trust Authority, aumentando a segurança do ambiente de datacenter e cloud.
Estratégia recomendada:
Se você está avaliando migração ou expansão de ambientes, o VCF9 é o caminho estratégico. Ele não só traz o vSphere 9, mas também padroniza infraestrutura e operações, garantindo suporte a novas tecnologias e maior agilidade para projetos de nuvem híbrida ou modernização de data centers.
VMware Cloud Foundation 9.0 – O que vem incluso ?
O VCF 9.0 simplifica o licenciamento ao trazer um arquivo único de licença para toda a infraestrutura. Antes, cada componente exigia chaves separadas, como vCenter, ESXi e add-ons. Agora, com o VCF9, os principais recursos inclusos no arquivo de licença são:
- VMware Cloud Foundation cores
- vSAN (até 1 TiB por core)
- Private AI Foundation
- vSphere Foundation cores
- VCF Edge cores
Serviços adicionais:
- Add-on via licença no arquivo:
- Private AI extra
- vSAN adicional (acima do limite incluso)
- Add-on via licença separada:
- VMware vDefend Firewall
- VMware Avi Load Balancer
- VMware Tanzu Platform
- VMware Data Services Manager
- SaaS:
- VMware Live Recovery
- Bundles via licença separada:
- VMware Telco Cloud Platform
Principais mudanças em relação às versões anteriores:
- Não há mais chaves separadas por componente ou versão.
- Licenciamento agora é agregado e escalável, permitindo distribuir a capacidade de licenças em múltiplos vCenters.
- Avaliação estendida de 60 para 90 dias.
- Licenciamento pode ser gerido nos modos Connected (automático) ou Disconnected (manual).
Olha, o VCF9 realmente soma. Ele traz várias melhorias legais, simplifica bastante a gestão e dá aquele up em compute, storage e rede. Agora, vamos ser sinceros: ele ainda não está pronto para absorver tudo do NSX e do VMware Cloud Director, principalmente quando falamos de ambientes multi-tenant de verdade. Por enquanto, ainda estamos no aguardo das melhorias que a Broadcom vai trazer para fechar essas lacunas e tornar a plataforma realmente completa para cenários complexos.
O VMware ESXi FREE Está de Volta!
Prepare-se para uma excelente notícia no mundo da virtualização: o VMware vSphere Hypervisor (ESXi) 8.0 U3 Grátis voltou!
Após o fim anunciado da versão gratuita, muitos profissionais de TI sentiram a perda de uma solução tão poderosa para laboratórios, testes e ambientes menores. Mas a Broadcom acaba de trazer de volta essa versão essencial, agora com base no vSphere 8.0 Update 3 (8.0 U3).
Sim, o ESXi Free Edition foi ressuscitado!
O Que Isso Significa?
A versão gratuita do VMware vSphere Hypervisor 8.0 já está disponível para download diretamente no portal de suporte da Broadcom. Essa versão oferece um hipervisor de nível básico, ideal para quem precisa de uma solução confiável, estável e de alta performance para ambientes standalone.
E o melhor:
✅ Download gratuito
✅ Chave de licença incluída no ISO
✅ Baseado na atualização mais recente (8.0 U3)
Baixe agora sua cópia oficial:
👉 Clique aqui para baixar
Por que isso importa?
Com a volta do ESXi Free, a comunidade ganha novamente uma ferramenta valiosa para:
- Laboratórios domésticos
- Ambientes de aprendizado
- Provas de conceito
- Pequenas infraestruturas locais
E, claro, é uma ótima forma de explorar os recursos do vSphere 8, mesmo sem um contrato comercial.
Continue acompanhando o TechPoli.info para mais novidades sobre virtualização, cloud, datacenter e o universo VMware.
Nos vemos na próxima postagem!