EUA exigem licença para exportar chips avançados de IA ao Brasil: o que muda?

Na segunda-feira, 16 de novembro, o Bureau of Industry and Security (BIS), o braço do Departamento de Comércio dos Estados Unidos que cuida de controle de exportação, divulgou uma regra que mexe direto com quem trabalha com datacenter e IA por aqui. A partir de agora, pra um chip avançado de IA chegar ao Brasil, alguém precisa pedir licença ao governo americano.

Não estamos sozinhos. Indonésia, Malásia, Singapura e Tailândia entraram na mesma lista. O alvo declarado é a China, e os cinco países foram classificados como destinos com “risco de desvio acima do normal”. A regra vale a partir da publicação oficial, prevista pra 19 de novembro, e fica 60 dias aberta a comentários.

Vale um contexto. Em janeiro de 2025, a regra do governo Biden (a AI Diffusion Rule) já tinha colocado o Brasil num grupo intermediário, com cotas. Ela nunca foi aplicada e foi formalmente revogada agora, no mesmo documento. Saiu o modelo de cotas por país, entrou a licença caso a caso.

Lendo as 117 páginas pra separar o que está escrito do que é manchete. Vamos ao que realmente importa.

Não é proibição. Mas também não é carimbo

Ninguém proibiu a venda de GPU pro Brasil. O que mudou é que existe uma autorização no meio do caminho.

É tipo visto americano. Você não está proibido de entrar, mas pega fila e mostra documento. E quem tem passaporte americano passa direto: se o destinatário ou o usuário final tem sede nos EUA, ou controladora final lá, não precisa de licença. Basta o exportador mandar um relatório mensal ao BIS.

Tem um detalhe no texto que pouca gente comentou. Pra outro grupo de países, a regra escreve com todas as letras “presunção de aprovação”. Pros cinco, ficou só o caso a caso, e o critério citado é a eficácia do controle de exportação do país de destino e a cooperação dele com o BIS. Ou seja: parte da resposta depende de Brasília, não do seu projeto.

Como os EUA decidem o que é “chip avançado”

A regra não cita marca nem modelo. Ela usa uma métrica chamada TPP (Total Processing Performance), e a conta é mais simples do que parece: o desempenho de pico da ficha técnica, em TFLOPS, multiplicado pelo tamanho da operação em bits.

A linha de corte é 4.800. Pega uma NVIDIA A100: 312 TFLOPS em 16 bits. 312 × 16 = 4.992. Passou por pouco, e eu duvido que seja coincidência. Uma H100, pelas minhas contas com a mesma fórmula, fica na casa de 16 mil.

Chips abaixo disso também entram, a partir de 1.600, se concentrarem muito desempenho em pouca área de silício.

Três pontos pra não errar :

  • Não é só GPU. O texto inclui TPUs, FPGAs, ASICs e qualquer acelerador que bata os parâmetros.
  • Não é toda GPU. Chip que não foi feito pra datacenter e fica abaixo de 4.800 está fora.
  • O servidor herda a classificação do chip. Basta um acelerador controlado dentro do chassi pro equipamento inteiro entrar na regra.

Sobre modelos: em 2023 a NVIDIA informou à SEC que A100, H100, L40, L40S e até a RTX 4090 estavam enquadradas. As gerações seguintes entregam mais, então a tendência é a mesma. Mas quem confirma a classificação de cada SKU é o fabricante, não eu.

Fabricado em Taiwan, montado no Brasil: tanto faz

Se o chip foi feito com tecnologia americana, a regra acompanha ele aonde for. O BIS usa exatamente esse exemplo: o chip incorporado a uma placa ou a um servidor produzido em outro país continua sob jurisdição americana.

E vale pra circulação dentro do Brasil. Revender um servidor com GPU controlada de uma empresa pra outra é uma “transferência dentro do país” e também pede licença. Inclusive equipamento usado.

O que muda na prática

Quem pede a licença é quem movimenta o equipamento: fabricante, distribuidor ou integrador. O comprador não preenche formulário, mas vai ter que informar quem é, quem controla a empresa, onde o equipamento vai ficar e quem vai usar.

Pra quem compra servidor com GPU, dá pra continuar comprando de Dell, HPE, Lenovo ou Supermicro. Só que a regra não define prazo de análise. Eu apostaria em entrega mais demorada e custo de compliance embutido no preço.

Pra quem tem pedido em andamento, a transição é curta. Só carga que já estava embarcada na data da publicação segue pela regra antiga, e a entrega precisa ser concluída em 30 dias.

Pra quem opera datacenter, o projeto de IA ganhou uma etapa a mais. O rack pode estar pronto, energia e refrigeração entregues, e o hardware parado esperando papel.

Pra quem vende GPU como serviço, vem a segunda frente da regra. Um datacenter, em qualquer país, precisa de licença se entregar mais de 12 milhões de TPP a empresas com sede ou controladora na China, em outros países restritos ou em Macau. Fazendo a conta, isso dá algo como 750 GPUs da classe H100. Não é número de hyperscaler, é um cluster de treinamento. E datacenters interligados somam, então dividir a carga entre sites não resolve.

Na prática, o provedor passa a ter obrigação de KYC (know your customer): saber quem é o cliente e quem está por trás dele. Se não conseguir comprovar isso pro fornecedor, a regra trata como sinal de alerta e a venda trava. Quem já presta esse tipo de serviço tem 90 dias pra se regularizar.

A conta que não fecha pro provedor nacional

A nuvem de capital americano que opera no Brasil entra pela exceção, com relatório mensal. O provedor brasileiro vai pra fila. A ABES chamou isso de “assimetria competitiva”, e eu concordo.

O próprio BIS, na estimativa de carga burocrática da regra, projeta cerca de 100 pedidos de licença a mais por ano, somando tudo. Pra cinco países, é muito pouco. Eles esperam que o grosso do volume passe pelas empresas americanas.

Do lado de cá, o MDIC disse, em nota reproduzida pela imprensa, que as exportações não foram proibidas e que ainda não dá pra medir o efeito.

O que eu faria agora

  • Pediria ao fabricante, por escrito, a classificação de exportação e o TPP de cada item do projeto.
  • Colocaria folga de prazo em todo cronograma de IA.
  • Deixaria pronta a documentação societária, até a controladora final.
  • Se vendesse capacidade de GPU, revisaria o cadastro e o contrato dos clientes.

Considerações

Durante anos, a pergunta num projeto de datacenter era “tem energia?” e “tem espaço?”. Agora entrou mais uma: “esse hardware chega quando?”. E a resposta não depende mais só do fabricante.

O que me preocupa é o sinal. O Brasil vem se vendendo como destino de datacenter de IA, com energia limpa e incentivo fiscal. O selo de “risco de desvio” atrapalha essa conversa, e isso não se resolve com engenharia. Resolve com diplomacia e com um controle de exportação que Washington reconheça.

Pra quem opera, nem pânico, nem descaso. Quem estiver com a classificação e a documentação em ordem vai receber hardware antes do concorrente.

Até a próxima, pessoal!
Continue Reading

VMware VCF e VVF: o que muda com os novos anúncios da Broadcom

Broadcom muda VCF e VVF: SRM, segurança e IA entre as principais novidades

A Broadcom trouxe mudanças importantes para o VMware Cloud Foundation (VCF) e o VMware vSphere Foundation (VVF) nos anúncios de 4 de novembro.

E não estamos falando apenas de novas funcionalidades. Temos mudanças no licenciamento, ampliação dos recursos de Disaster Recovery, novas camadas de segurança e investimentos em infraestrutura para inteligência artificial.

Mas existe um detalhe importante: nem tudo está incluído na assinatura. Algumas funcionalidades já estão disponíveis, outras estão no roadmap e parte delas será comercializada como serviço adicional.

Vamos ao que realmente importa.

O que muda na prática?

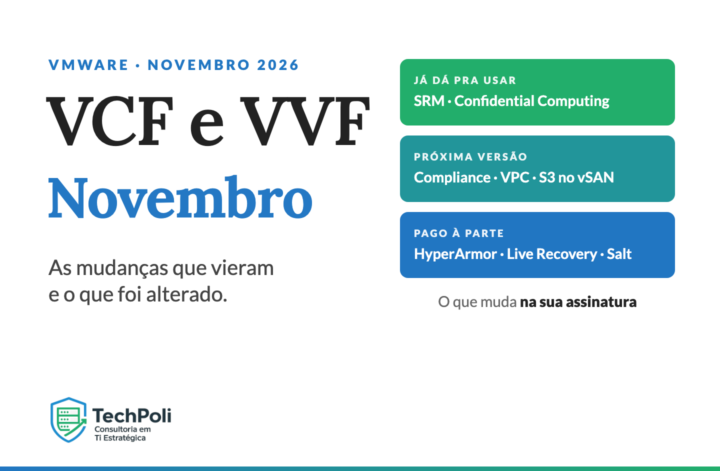
Antes de entrar nos detalhes, veja como ficam os principais anúncios:

CategoriaNovidades
Já disponívelSRM para assinantes VCF/VVF, Confidential Computing e Multi-tenant Model Sharing
Próximas versõesCompliance de infraestrutura, VPC por políticas, S3 no vSAN e AI Infrastructure Quickstart
Contratação adicionalHyperArmor, Live Recovery e Compliance and Configuration Management

Essa separação é fundamental para quem administra ambientes VMware e precisa avaliar impacto técnico, licenciamento e orçamento.

1. SRM agora faz parte do VCF e VVF

Essa é provavelmente a novidade que merece mais atenção.

Desde 2 de novembro, o Site Recovery Manager (SRM) deixou de ser comercializado como produto independente. Clientes com assinatura ativa de VCF ou VVF passam a ter direito de uso da solução, conforme a KB 461219 da Broadcom.

Para quem já utiliza SRM, existem duas possibilidades:

  • Chave temporária: disponível no Support Portal, com proteção de até 10 mil VMs e validade até 2 de maio de 2027.
  • Nova versão: o direito de uso será incorporado ao VCF/VVF 9.1.3, exigindo Protection and Recovery 9.1.3 e vCenter 9.1 ou superior.

Atenção a dois detalhes: a chave temporária fica em My Downloads, na área de VCF/VVF 9.1, e licenças perpétuas não estão contempladas, mesmo com suporte ativo.

Meu conselho: quem utiliza SRM precisa começar a planejar essa transição agora. Não deixe para resolver na última janela de manutenção antes de maio de 2027.

2. Compliance: uma parte será nativa, outra será paga

A Broadcom está separando o compliance em duas frentes:

Infraestrutura: será integrado ao VCF Operations, permitindo monitorar configurações de componentes como vCenter e VCF Storage, identificar desvios e aplicar correções com base em referências como PCI e VCF Security Baseline.

Workloads: o VMware Compliance and Configuration Management será um Advanced Service, com contratação adicional. Seu foco são os sistemas operacionais e workloads dentro das VMs e containers, utilizando benchmarks CIS e políticas personalizadas.

A tecnologia por trás dessa solução é o VMware Salt.

Um detalhe interessante: o Salt já faz parte do ecossistema VMware há alguns anos. O que muda agora é a oferta comercial e a camada de gerenciamento, governança e automação em escala.

Para quem deseja experimentar, o Salt open source permite testar o conceito de configuration drift localmente: É um exemplo simples, mas demonstra bem a proposta: identificar quando uma configuração sai do padrão e restaurar a conformidade.

3. HyperArmor: segurança diretamente no ESXi

O HyperArmor chega com uma proposta interessante: adicionar mecanismos de proteção diretamente ao hypervisor.

Entre os recursos anunciados estão:

  • Virtual patching: proteção contra exploração de vulnerabilidades sem depender imediatamente da aplicação de patches e reboot do host.
  • Segurança positiva: controle dos processos autorizados a executar no ESXi.
  • MFA no SSH: autenticação adicional por código TOTP no acesso ao hypervisor.

Para quem administra grandes ambientes VMware, principalmente com muitos hosts ESXi, a proposta de virtual patching chama bastante atenção.

A previsão de lançamento divulgada está no primeiro trimestre de 2027. O serviço terá contratação adicional.

4. SRM e Live Recovery não são a mesma coisa

É importante não confundir essas duas soluções.

SoluçãoPrincipal finalidade
SRMRecuperação de desastres e continuidade entre sites
VMware Live RecoveryRecuperação de workloads após ataques cibernéticos, especialmente ransomware

O Live Recovery trabalha com isolamento (air gap), replicação para ambientes de recuperação e validação dos workloads antes do retorno à produção.

Para empresas que já utilizam Veeam, por exemplo, vale analisar cuidadosamente a sobreposição de funcionalidades antes de contratar mais uma solução.

O ponto não é adicionar ferramentas, mas identificar onde existe ganho real de proteção.

5. O que vem por aí: VPC, S3 e infraestrutura para IA

Além das mudanças comerciais, a Broadcom apresentou novidades que devem chegar às próximas versões do VCF.

Os principais destaques são:

VPC com conectividade por políticas

Provisionamento de redes em modelo self-service, permitindo que equipes de plataforma definam políticas de isolamento e conectividade sem depender de chamados para cada alteração.

S3 nativo no vSAN

Object storage compatível com S3 integrado ao vSAN, com aplicações em ambientes cloud-native, IA e backup. A funcionalidade já estava em Tech Preview no VCF 9.1.1.

AI Infrastructure Quickstart

Um plugin para o vCenter que simplifica a implantação de infraestrutura para IA, automatizando etapas de configuração de clusters, Supervisor e VMware Kubernetes Service (VKS).

E duas funcionalidades já estão disponíveis:

  • Confidential Computing (VCF 9.1): suporte a AMD SEV-SNP e Intel TDX para proteger workloads durante o processamento.
  • Multi-tenant Model Sharing (VCF 9.1.1): compartilhamento de modelos de IA entre diferentes tenants, mantendo o isolamento e melhorando o aproveitamento das GPUs.

A direção é clara: o VCF está deixando de ser apenas uma plataforma de virtualização e avançando para uma infraestrutura completa de private cloud, automação e inteligência artificial.

O que merece atenção?

Na minha visão, três pontos precisam entrar na análise de qualquer empresa que utiliza VMware:

1. Revise seus direitos de licenciamento. Nem tudo que foi anunciado está incluído na assinatura. Diferencie funcionalidades disponíveis, roadmap e Advanced Services.

2. Planeje a transição do SRM. Existe uma data-limite para a chave temporária. Compatibilidade e atualização precisam entrar no planejamento operacional.

3. Avalie o que você já possui. Antes de contratar Live Recovery, HyperArmor ou novas soluções de compliance, compare as funcionalidades com as ferramentas existentes no ambiente.

A Broadcom está ampliando o VCF, mas isso também exige avaliação de arquitetura, custos e estratégia de proteção.

Para quem trabalha com datacenter e cloud, acompanhar essas mudanças deixou de ser apenas uma questão de conhecer novas funcionalidades. É uma questão de tomar decisões melhores sobre a infraestrutura que sustenta o negócio.

Para experimentar: o laboratório HOL-2734-05-VCF-L, VMware Salt in VCF 9.1, está disponível no VMware Hands-on Labs.

Até a próxima!

Continue Reading

Dell Technologies Forum 2026 – São Paulo

Se o IBM TechXchange foi a IBM tentando colocar limites em agentes de IA, o Dell Technologies Forum foi a Dell me sentando numa bancada e falando: então sobe um você mesmo.

Semana cheia em São Paulo. No dia 5 de novembro, passei pelo Transamerica Expo Center para o Dell Technologies Forum Brasil 2026, o principal evento da Dell no país. E, dessa vez, o melhor do evento não estava no palco. Estava num laboratório.

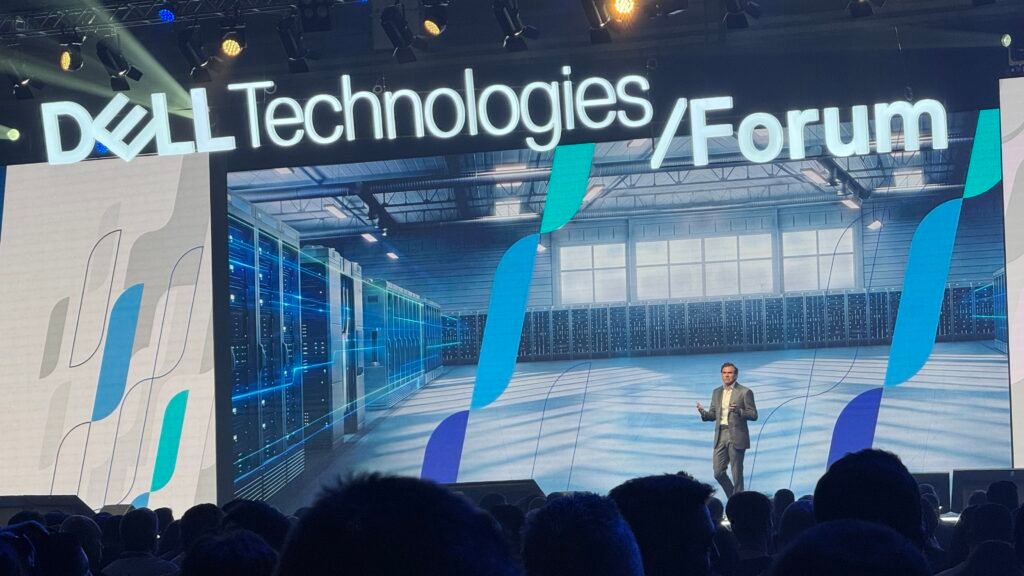
O recado do palco: chega de piloto

A plenária de abertura ficou com o Diego Puerta, presidente da Dell no Brasil, e o tema do dia dá pra resumir assim: a fase de brincar com IA acabou, agora é escalar. Sair do piloto que impressiona na reunião e chegar no projeto que roda em produção e fecha a conta.

Três assuntos apareceram o tempo todo:

  • IA agêntica: o agente que não só responde, mas executa tarefa e coordena etapa de trabalho.
  • Onde rodar: nuvem pública, ambiente privado ou híbrido, com controle sobre os dados e custo previsível.
  • Tokenomics: quanto custa, de verdade, cada operação de IA. Token virou linha de orçamento.

Pra quem vive de datacenter e cloud, esse terceiro ponto é música. Quando a conta de token chega, a conversa sobre rodar inferência em casa deixa de ser ideologia e vira planilha.

NemoClaw Lab: a parte boa

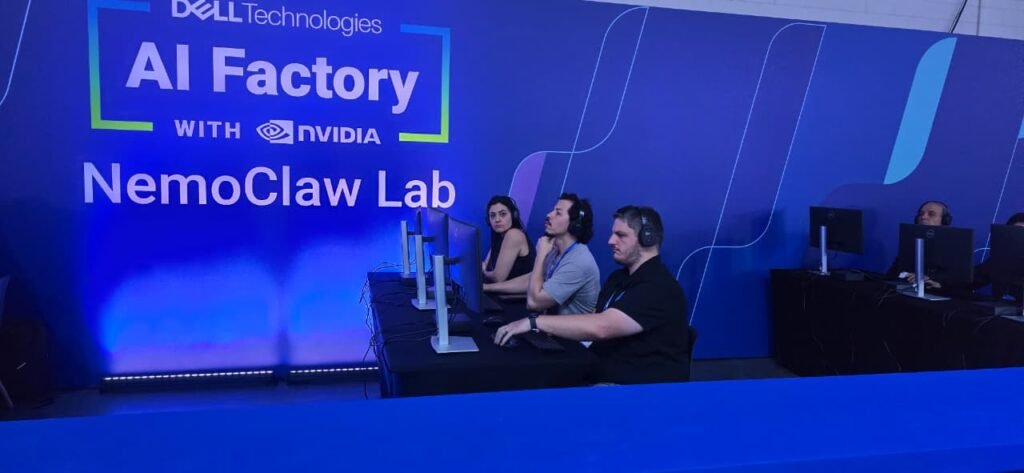
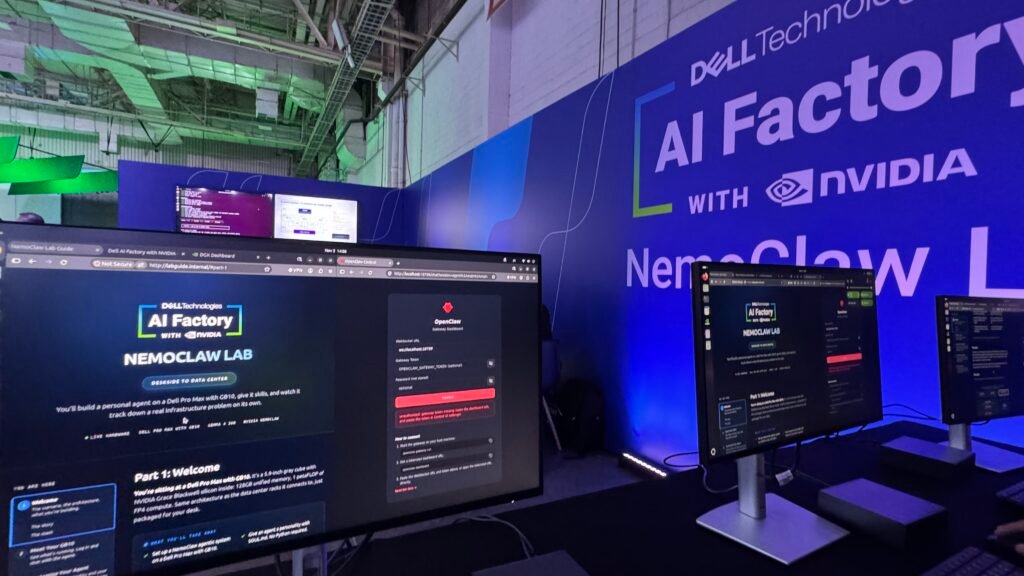
O Brasil foi um dos nove países escolhidos pra receber o NemoClaw Lab, um laboratório hands-on dentro do espaço da Dell AI Factory with NVIDIA. Bancada, monitor, fone no ouvido e um instrutor guiando a turma. Sem slide bonito: é terminal, dashboard e agente rodando.

Pra quem não acompanhou: o NemoClaw é a stack open source que a NVIDIA lançou no GTC deste ano pra rodar agentes de IA com cara de empresa. São três peças:

  • OpenClaw: o framework do agente, aquele que conversa, chama ferramenta e executa tarefa.
  • OpenShell: o runtime de segurança. O agente roda dentro de um sandbox, com política dizendo o que ele pode ou não pode tocar.
  • Nemotron: os modelos abertos da NVIDIA, rodando local.

É dar um estagiário muito rápido pra sua empresa, só que dentro de uma sala de vidro: ele trabalha, você vê tudo, e a porta só abre pra onde você deixou.

Com o grande Rogerio Chola

Quem conduziu o laboratório foi o grande Chola, da Dell. E aqui vai um elogio sincero: lab de evento costuma ser copiar e colar comando sem entender nada. Esse não foi. Ele explicou o porquê de cada etapa, e isso muda tudo.

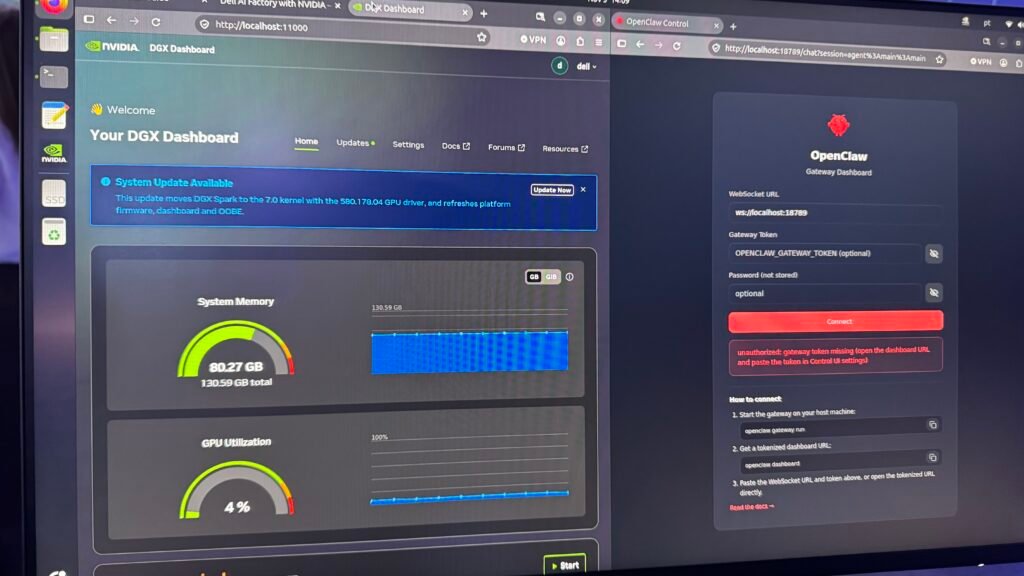
O roteiro foi subir o NemoClaw na máquina, colocar o agente no ar dentro do sandbox e conversar com ele. Tudo local. Nada de API de terceiro, nada de dado saindo da bancada.

Repara na foto. Do lado esquerdo, o dashboard: cerca de 80 GB de memória em uso, de 130 GB no total, e a GPU descansando em 6% enquanto o agente espera a próxima pergunta. Do lado direito, o chat com o assistente. O modelo inteiro carregado na memória de uma máquina que cabe em cima da mesa.

Há dois anos, isso era projeto de cluster. Hoje é uma caixinha do lado do monitor.

Por que isso importa

No post do TechXchange eu comentei o número que a IBM levou pro palco: só uns 25% dos agentes de IA estão prontos pra rodar em empresa. O resto é prompt solto com acesso a sistema de produção.

O NemoClaw ataca exatamente esse problema, só que por baixo. A IBM quer ser a camada de governança por cima dos agentes. A NVIDIA, com a Dell entregando o ferro, quer que o agente já nasça dentro da cerca. São abordagens que se completam, e as duas dizem a mesma coisa: agente sem controle não entra em produção.

E tem o lado da infraestrutura, que é o que me interessa. Agente rodando local significa dado dentro de casa, latência baixa e custo previsível. É o tokenomics da plenária aparecendo na prática.

Minhas considerações

Saí do Transamerica com três coisas na cabeça:

  • Agente de IA virou assunto de infraestrutura: não é mais só coisa de desenvolvedor. Quem cuida de datacenter vai ter que saber onde esse agente roda, com que modelo e com que permissão.
  • Segurança vem antes do agente: sandbox e política não são opcional. São o que separa demo de produção.
  • Hands-on vale mais que keynote: uma hora de bancada me ensinou mais sobre agente do que dez palestras.

Foi uma experiência incrível. Ver o agente subir, responder e ficar preso dentro das regras que a gente definiu deixa bem mais claro o que é hype e o que já funciona.

Meu agradecimento ao Chola e ao time da Dell pelo laboratório. Se o NemoClaw Lab aparecer num evento perto de você, senta na bancada.

Até o próximo evento, pessoal!

Continue Reading

DCD Connect 2026 e The Xcelerated Compute Show

Nos dias 4 e 5 de novembro, estive no Sheraton WTC, em São Paulo, acompanhando o DCD Connect Brasil 2026 e o The Xcelerated Compute Show. Foram dois dias de discussões sobre energia, infraestrutura para inteligência artificial, refrigeração e novos modelos de negócio para o setor.

O evento reuniu mais de 3,2 mil participantes, 170 palestrantes e 160 expositores. Além dos painéis tradicionais do DCD Connect, a programação contou com o Investment Forum e um espaço dedicado à computação acelerada, com a NVIDIA como lead partner.

Energia: o principal gargalo da IA

Um dos debates mais relevantes foi direto ao ponto: sem energia não há IA. Um dado apresentado durante o painel chamou atenção: a construção de um grande data center pode levar de 2 a 4 anos, enquanto a expansão da infraestrutura elétrica necessária pode levar de 6 a 8 anos.

Os pedidos de conexão, antes na faixa de 10 ou 20 MW, já chegam a 200 MW, e há projetos discutindo demandas de até 1 GW. Ou seja, o desafio não está apenas em comprar GPUs: é preciso conseguir energia para mantê-las operando.

A Ascenty apresentou o exemplo de Sumaré, onde investiu cerca de R$ 200 milhões em uma linha própria de 35 km para conectar seu campus a uma subestação. A discussão sobre permitir maior participação dos operadores na construção da infraestrutura elétrica merece atenção.

Outro ponto interessante foi a possibilidade de utilizar baterias, UPS e geradores dos data centers como recursos de flexibilidade para a rede elétrica, ajudando a reduzir picos de consumo. Se houver evolução regulatória, ativos que hoje ficam grande parte do tempo em espera poderão ter um papel adicional.

Também ficou claro que nem toda carga de IA precisa estar perto dos grandes centros consumidores. Treinamento e determinadas aplicações de inferência podem operar em regiões com energia e conectividade disponíveis. Isso abre espaço para novos polos fora do eixo Rio–São Paulo.

O mapa dos investimentos: Ceará em destaque

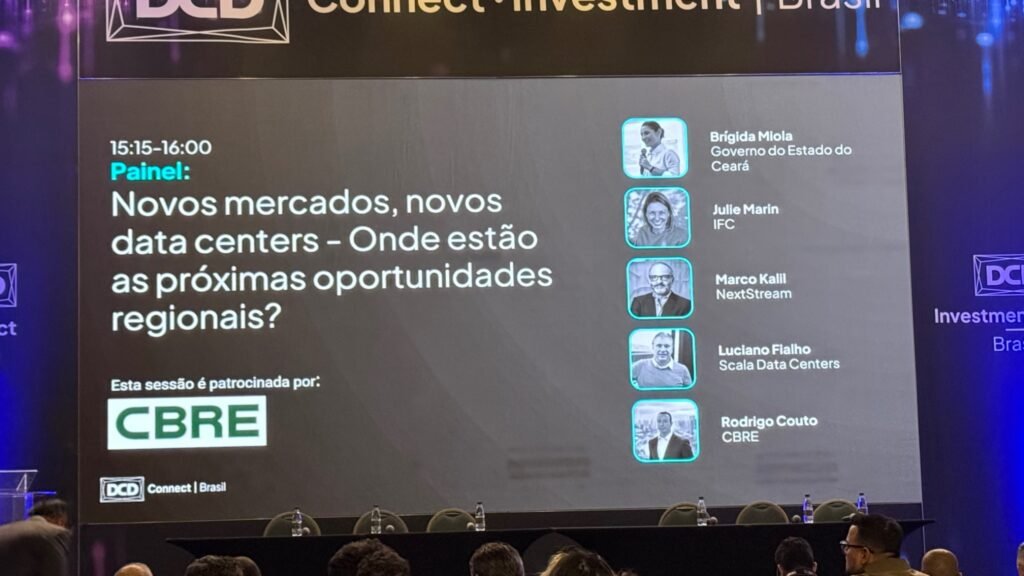
O painel “Novos mercados, novos data centers” reuniu representantes do Governo do Ceará, IFC, NextStream, Scala Data Centers e CBRE. A presença do Ceará na discussão não foi por acaso: o estado combina disponibilidade energética, conectividade internacional e projetos relevantes de infraestrutura digital, especialmente na região do Pecém.

Uma ausência que me chamou atenção foi Santa Catarina. Temos operadores, conectividade e uma posição interessante no Sul do país, mas ainda precisamos avançar para entrar com mais força nesse mapa de investimentos. Vejo nisso um desafio, mas também uma oportunidade.

Cooling: não existe uma solução única

Com o aumento da densidade das GPUs, a refrigeração deixou de ser um detalhe de projeto. Entre as alternativas discutidas, três tecnologias se destacam:

  • Rear Door Heat Exchanger (RDHx): trocador de calor na porta traseira do rack. Pode ser um caminho para ampliar a densidade em salas existentes, sem uma reforma completa.
  • Direct-to-Chip: líquido circula por cold plates instaladas diretamente nos componentes, como CPUs e GPUs. É indicado para ambientes de alta densidade e HPC.
  • Immersion Cooling: servidores submersos em fluido dielétrico. É uma alternativa para cenários de densidade e exigência térmica extremas.

Como referência, a refrigeração a ar costuma atender racks na faixa de 10 a 15 kW, enquanto soluções líquidas podem chegar a densidades próximas de 100 kW por rack, conforme a arquitetura. Para quem já opera salas convencionais, a porta traseira pode ser um passo intermediário antes de partir para soluções mais complexas.

AI Factory por assinatura

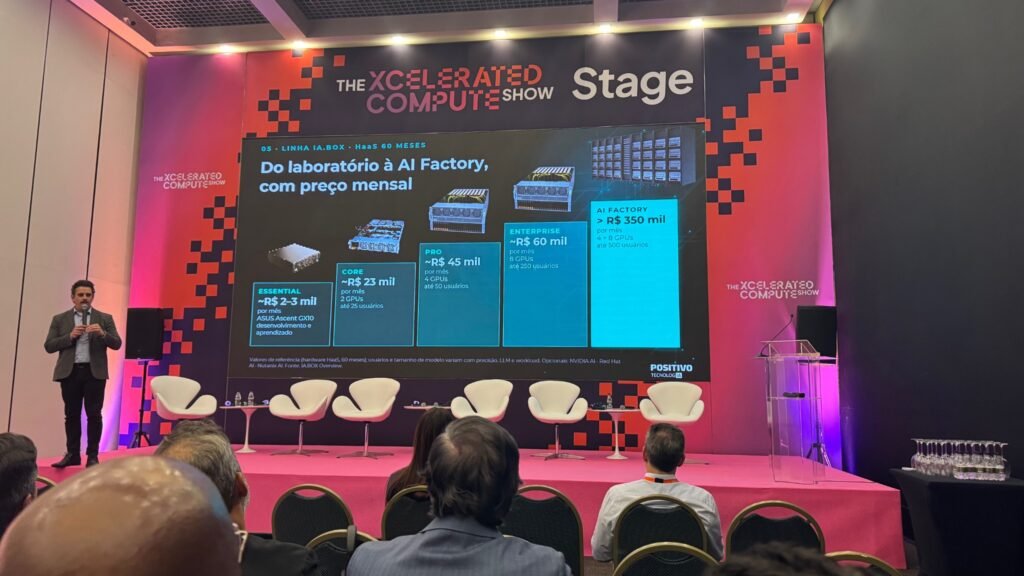
No The Xcelerated Compute Show, a Positivo apresentou a linha IA Box, baseada no modelo Hardware as a Service (HaaS): em vez de comprar toda a infraestrutura, o cliente contrata uma mensalidade e mantém o equipamento em seu próprio ambiente.

Os valores de referência exibidos no evento, para contratos de 60 meses, foram:

  • Essential: R$ 2 mil a R$ 3 mil/mês, com ASUS Ascent GX10.
  • Core: cerca de R$ 23 mil/mês, 2 GPUs e até 25 usuários.
  • Pro: cerca de R$ 45 mil/mês, 4 GPUs e até 50 usuários.
  • Enterprise: cerca de R$ 60 mil/mês, 6 GPUs e até 250 usuários.
  • AI Factory: acima de R$ 350 mil/mês, com 4 ou mais GPUs e até 500 usuários.

A proposta chama atenção por ocupar um espaço entre consumir IA por APIs de hyperscalers e investir milhões em um cluster próprio. Para empresas que precisam manter dados e processamento sob seu controle, mas preferem evitar um CAPEX elevado, esse modelo pode fazer sentido.

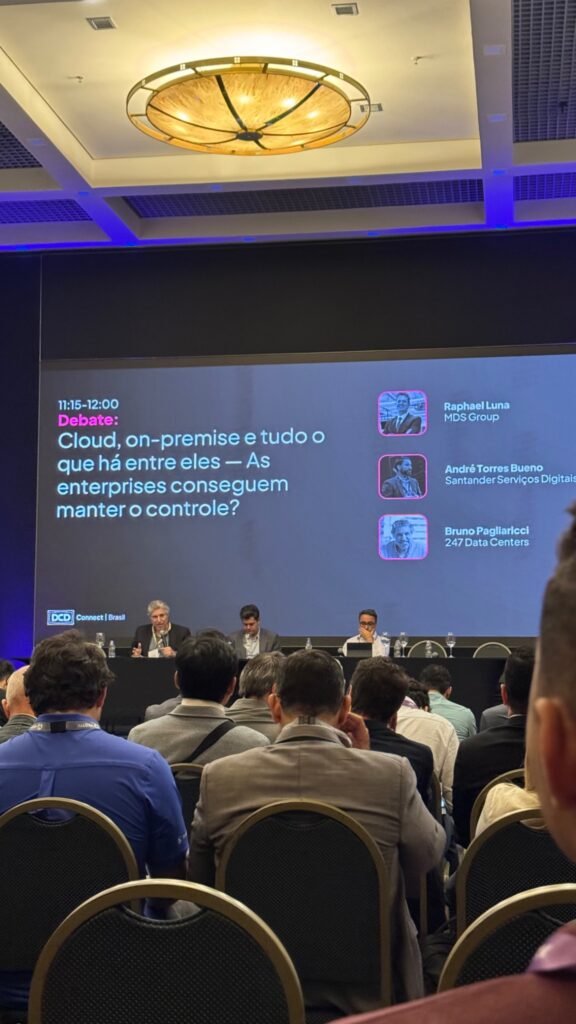
Cloud, on-premise e o modelo híbrido

Outro debate abordou como as empresas podem manter o controle em ambientes que combinam cloud pública, infraestrutura própria e modelos híbridos.

Na prática, a decisão não deveria ser simplesmente cloud ou on-premise. Cada workload precisa estar no ambiente mais adequado, considerando custo, desempenho, segurança, latência, disponibilidade e requisitos regulatórios. O desafio é manter governança e visibilidade sobre toda essa operação.

O que fica do DCD Connect 2026

Minha principal impressão é que a expansão da inteligência artificial está trazendo o debate de volta aos fundamentos da infraestrutura. Antes de falar em grandes clusters, precisamos resolver energia, refrigeração, conectividade e capacidade física.

Três pontos resumem o que levo do evento:

  • Energia é estratégica: precisa entrar no planejamento desde o início, pois pode definir onde e quando um data center será viável.
  • Cooling precisa acompanhar a densidade: a tecnologia deve ser escolhida conforme o workload, a infraestrutura existente e o TCO.
  • IA como serviço abre novas oportunidades: existe mercado entre a API de terceiros e o investimento em infraestrutura própria.

Estamos entrando em uma nova fase para os data centers. A inteligência artificial não muda apenas os servidores: muda o planejamento de energia, refrigeração, conectividade, armazenamento e os próprios modelos de negócio.

O Brasil tem potencial para ocupar um espaço importante nessa transformação. A questão é se conseguiremos transformar esse potencial em infraestrutura digital, com energia e capacidade disponíveis onde o mercado precisa.

Até o próximo evento, pessoal!

Continue Reading

vSphere Express: a Broadcom lembrou do cliente pequeno

No Day 3 do Explore, em setembro, a Broadcom admitiu em público que tinha largado o vSphere Standard pra trás. Dois meses depois, veio a resposta: o vSphere Express, anunciado no dia 4 de novembro junto com a atualização do portfólio VCF.

É uma edição de entrada, em cima do vSphere 9, pra quem quer continuar no hypervisor da VMware e não precisa (nem quer pagar) uma private cloud inteira. Já está disponível em todas as regiões, só em assinatura e vendido via distribuidor.

O que vem no pacote

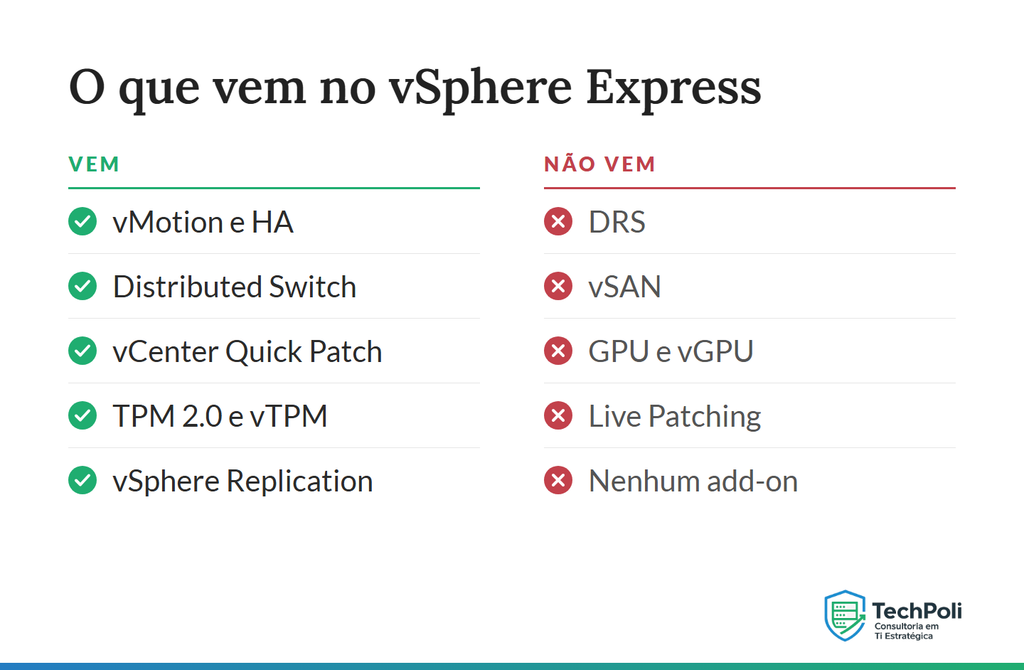
vSphere 9 com ESX e vCenter, vMotion (mais rápido que no 8), HA, Distributed Switch, vCenter Quick Patch e suporte a TPM 2.0 e vTPM 2.0. O vSphere Replication entra como componente opcional. Pra licenciar, você sobe um VCF Operations e um license server, mas no Express o VCF Operations serve só pra isso: gestão de licença. Nada de monitoramento, nada de capacity.

Na prática, é o vSphere Standard que a gente conhecia, com o Distributed Switch de presente.

O que fica de fora

DRS não vem. GPU e vGPU, Memory Tiering, SR-IOV, Proactive HA e Live Patching também não. VCF Automation e Private AI, nem pensar.

E o vSAN também não. Fui conferir na documentação técnica da Broadcom: o vSAN não está na lista de componentes do Express, e a própria documentação diz que o Express não aceita nenhum add-on. Como o vSAN hoje só existe como capacidade incluída no VVF e no VCF, ou como add-on deles, quem quer HCI com vSAN precisa subir de edição. No Express, o storage é o que você já tem: array, NAS, NFS ou disco local.

128 cores, nem um a mais

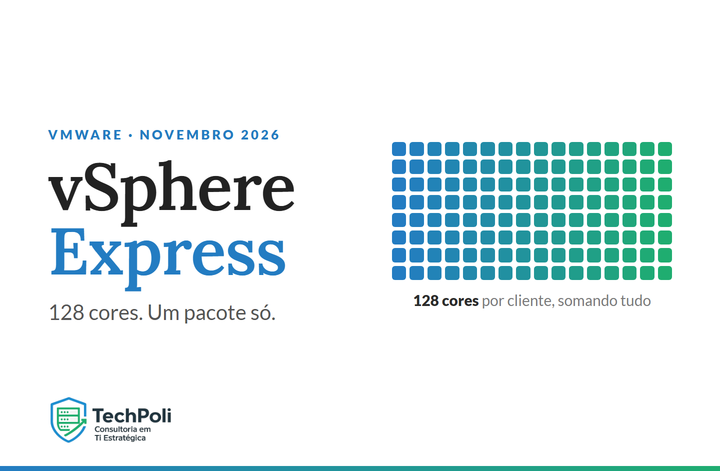
Aqui está o detalhe que muda a conta. O Express tem limite de 128 cores por cliente, somando todos os ambientes. Não é por cluster, é pela empresa inteira. A licença não pode ser dividida nem compartilhada entre sites, e não existe segundo pacote: passou de 128, o caminho é VVF ou VCF.

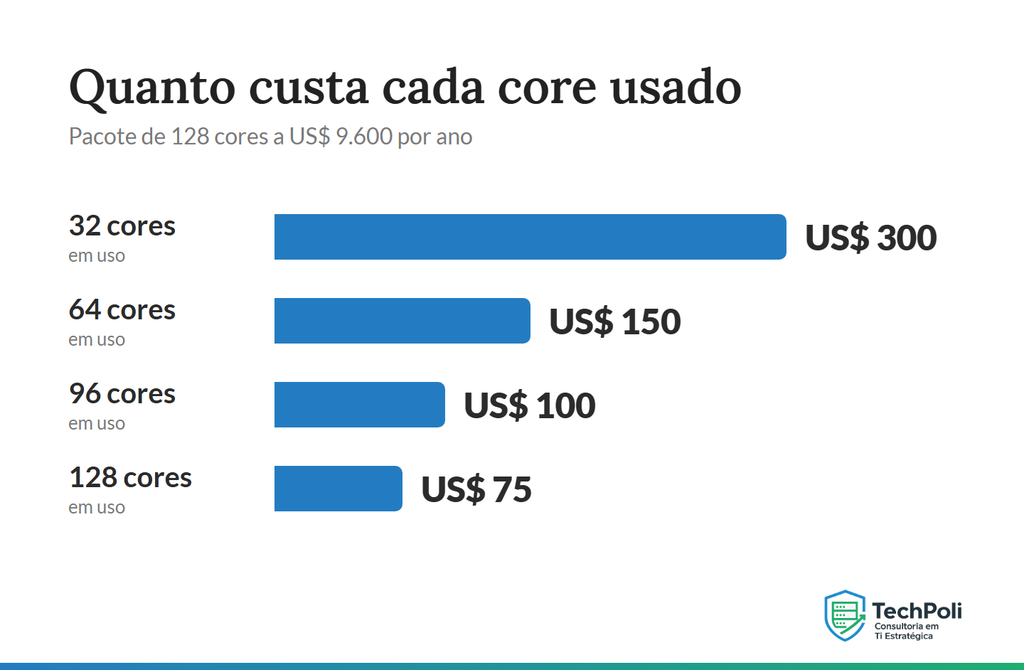
E o pacote é fechado. Lá fora, a TD SYNNEX lista o Express a US$ 9.600 por ano, uns US$ 75 por core. A Broadcom não divulgou preço oficial e no Brasil ainda não tem número, então é referência.

A conta que importa é o custo por core que você realmente usa:

  • 32 cores em uso: US$ 300 por core/ano
  • 64 cores em uso: US$ 150 por core/ano
  • 96 cores em uso: US$ 100 por core/ano
  • 128 cores em uso: US$ 75 por core/ano

É tipo plano anual de academia: o preço é ótimo se você vai todo dia. Se vai duas vezes por semana, cada treino sai caro.

Sobre quem pode comprar: pelo que os distribuidores estão passando, entra cliente novo (quem nunca comprou VMware ou não compra há três anos) e cliente atual que a Broadcom liberar. Todo pedido passa por aprovação da Broadcom, que pode recusar mesmo depois do pedido feito. Contrato de um ano.

Cada instância é uma ilha

Pra mim, esse é o ponto mais importante, mais até que o preço. Cada instância do Express é independente, sem gerenciamento central entre elas. Ter um vCenter pra administrar um ambiente é uma coisa. Ter uma plataforma pra operar vários ambientes e clusters de um lugar só é outra bem diferente.

Pra quem tem um datacenter pequeno, tanto faz. Pra MSP e provedor de cloud, é o que tira o Express da mesa. Some isso à falta de DRS e ao teto de 128 cores e fica claro que a Broadcom não quer esse produto rodando em escala. O VP de marketing de produto do VCF disse isso com todas as letras: não quer ver cliente rodando Express em milhares de cores.

Express, VVF e VCF

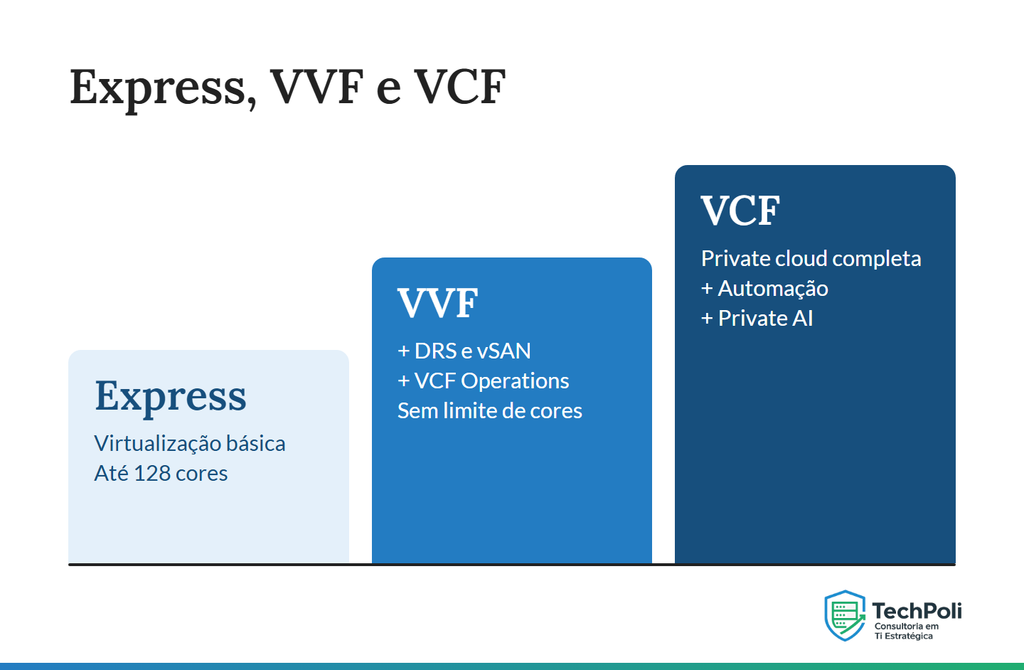
A divisão ficou bem desenhada:

  • Express: virtualização básica, até 128 cores.
  • VVF: virtualização com DRS, vSAN e VCF Operations completo.
  • VCF: a private cloud inteira, com automação e Private AI.

E o caminho de subida existe. Dá pra aplicar licença de VVF em cima do ambiente Express, ou usar o Express como ponto de partida pra um VCF completo. Quem ainda está no vSphere 8 (vCenter e ESXi 8.0 em diante) migra direto pro Express 9.1.1.

Pra quem faz sentido

Faz sentido pra pequena empresa que quer continuar no VMware sem aprender plataforma nova, filial ou ambiente isolado, datacenter corporativo pequeno, laboratório e homologação. E principalmente pra quem estava parado no vSphere Standard 8 sem saber pra onde ir.

Não faz sentido pra provedor de cloud, MSP, ambiente acima de 128 cores, nem pra quem depende de DRS, vSAN ou GPU.

O resto do anúncio

No mesmo pacote de novidades, a Broadcom anunciou o VMware HyperArmor (virtual patching do ESX e MFA no SSH) e o VMware Live Recovery, com clean room pra recuperação de ataque cibernético. Pra próxima versão do VCF, prevista pro primeiro trimestre fiscal de 2027, ficaram o vSAN com storage de objetos compatível com S3, o AI Infrastructure Quickstart e disaster recovery orquestrado pra VCF e VVF. O VCF 9.1.1 está disponível desde 3 de setembro.

Minhas considerações

Depois de dois anos empurrando todo mundo pro VCF, a Broadcom viu o que estava acontecendo na ponta de baixo: cliente pequeno indo pra Proxmox, Hyper-V, Nutanix AHV e OpenStack. O Express é a tentativa de segurar (ou trazer de volta) esse pessoal.

O produto faz sentido. O que pode atrapalhar é o desenho comercial: pacote fixo de 128 cores, um por cliente, aprovação da Broadcom e contrato de um ano. Pra quem foi surpreendido por mudança de licenciamento nos últimos dois anos, confiança não volta com SKU novo. Volta com previsibilidade.

É uma boa notícia pra empresa pequena que gosta de VMware e não quer trocar de plataforma. Pra provedor de cloud, não muda nada.

Eu ficaria de olho em três coisas: o preço oficial no Brasil, a regra de elegibilidade pra quem já é cliente e se a Broadcom vai mesmo manter o Express no mesmo ritmo de release do VVF e do VCF, como prometeu.

Até a próxima, pessoal!
Continue Reading